Qwen 发布 Qwen3.6-35B-A3B 开源权重模型
Qwen/Qwen3.6-35B-A3B
Qwen 团队发布 Qwen3.6 系列首个开源权重版本 Qwen3.6-35B-A3B,总参数 35B、激活 3B,原生上下文 262,144 tokens 并可扩展至 1,010,000 tokens。
同一件事,精选收录的是《Qwen 发布 Qwen3.6-35B-A3B-FP8 开源权重》

该仓库包含以 HF Mirror Transformers 格式提供的后训练模型的模型权重和配置文件。
这些产物与 HF Mirror Transformers、vLLM、SGLang、KTransformers 等兼容。
在 Qwen3.5 系列于二月发布之后,我们很高兴分享 Qwen3.6 的首个开放权重变体。基于社区的直接反馈构建,Qwen3.6 优先考虑稳定性和实际实用性,为开发者提供更直观、更响应迅速且真正高效的编码体验。
Qwen3.6 亮点
本次发布带来了大幅升级,尤其是在以下方面
- 智能体编码:该模型现在能够以更高的流畅度和精度处理前端工作流和仓库级推理。
- 思维保留:我们引入了一个新选项,可保留历史消息中的推理上下文,从而简化迭代开发并减少开销。
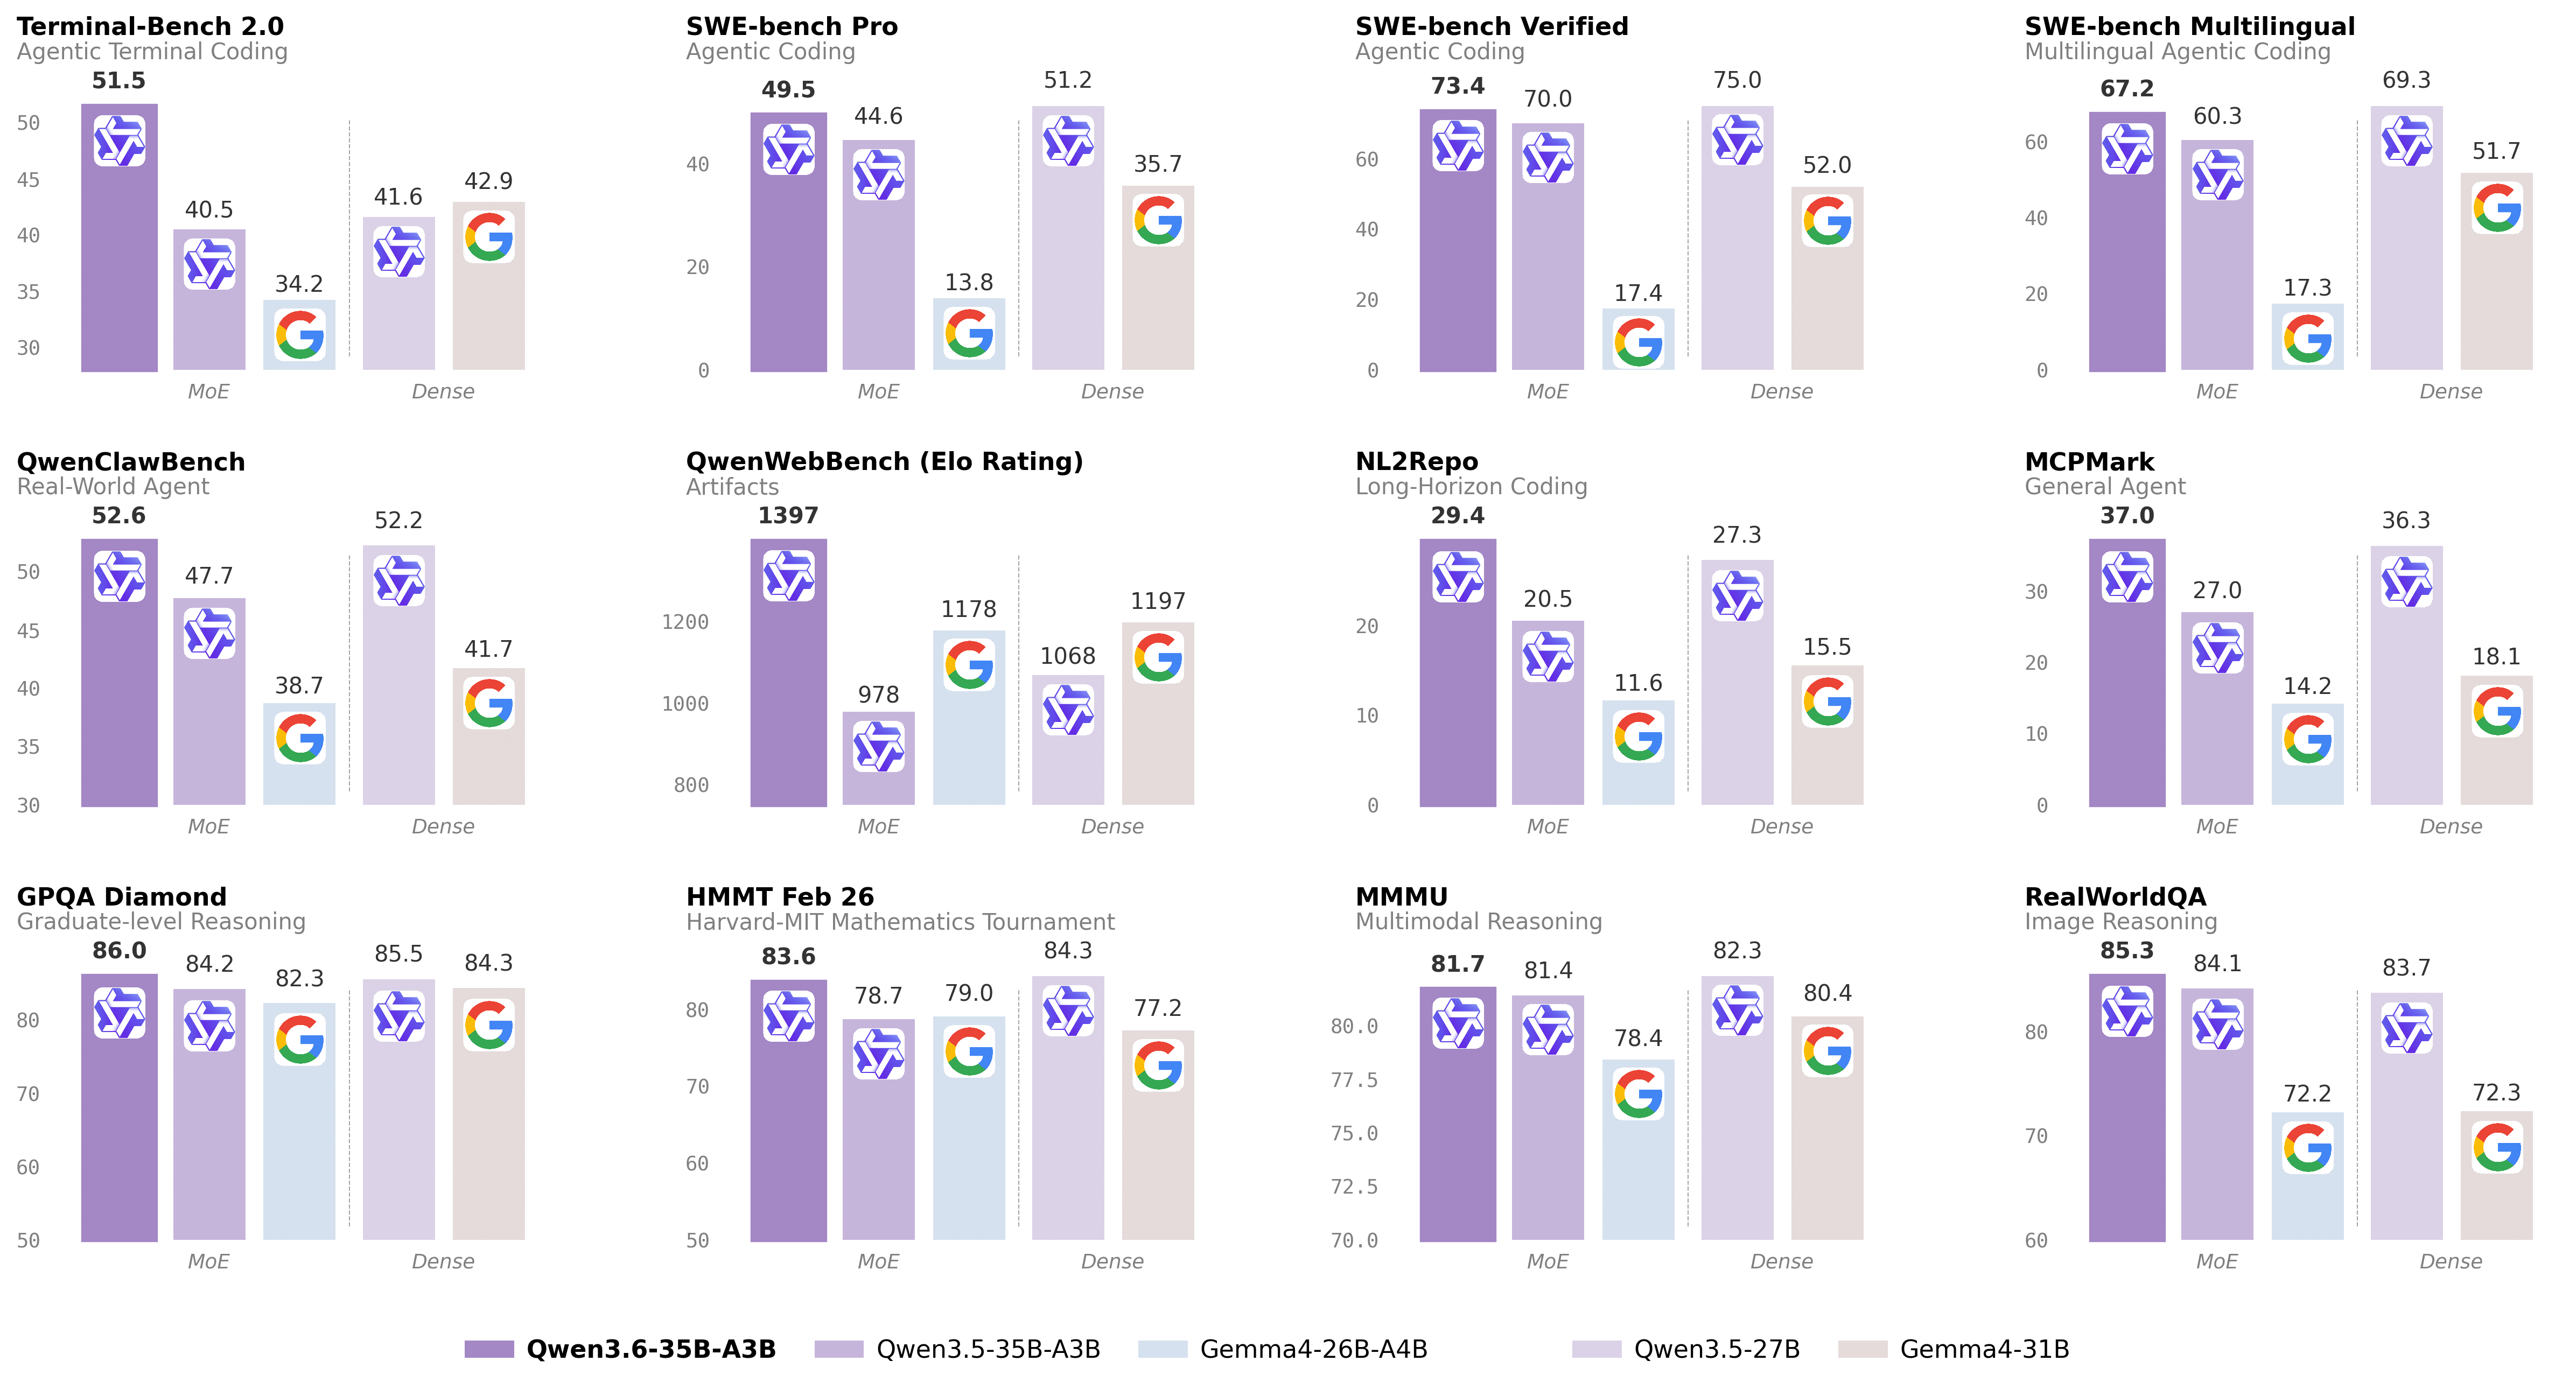
更多详情,请参阅我们的博客文章 Qwen3.6-35B-A3B。
模型概览
- 类型:带视觉编码器的因果语言模型
- 训练阶段:预训练与后训练
- Language Model
- 参数量:总计 35B,激活 3B
- 隐藏维度:2048
- Token 嵌入:248320(填充)
- 层数:40
- 隐藏层布局:10 × (3 × (Gated DeltaNet → MoE) → 1 × (Gated Attention → MoE))
- Gated DeltaNet:
- 线性注意力头数:V 为 32,QK 为 16
- 头维度:128
- Gated Attention:
- 注意力头数:Q 为 16,KV 为 2
- 头维度:256
- 旋转位置嵌入维度:64
- Mixture Of Experts
- 专家数量:256
- 激活专家数量:8 个路由 + 1 个共享
- 专家中间维度:512
- LM 输出:248320(填充)
- MTP:使用多步训练
- 上下文长度:原生 262,144,可扩展至 1,010,000 个 token。
基准测试结果
语言
| Qwen3.5-27B | Gemma4-31B | Qwen3.5-35BA3B | Gemma4-26BA4B | Qwen3.6-35BA3B | |
|---|---|---|---|---|---|
| 编码智能体 | |||||
| SWE-bench Verified | 75.0 | 52.0 | 70.0 | 17.4 | 73.4 |
| SWE-bench Multilingual | 69.3 | 51.7 | 60.3 | 17.3 | 67.2 |
| SWE-bench Pro | 51.2 | 35.7 | 44.6 | 13.8 | 49.5 |
| Terminal-Bench 2.0 | 41.6 | 42.9 | 40.5 | 34.2 | 51.5 |
| Claw-Eval Avg | 64.3 | 48.5 | 65.4 | 58.8 | 68.7 |
| Claw-Eval Pass^3 | 46.2 | 25.0 | 51.0 | 28.0 | 50.0 |
| SkillsBench Avg5 | 27.2 | 23.6 | 4.4 | 12.3 | 28.7 |
| QwenClawBench | 52.2 | 41.7 | 47.7 | 38.7 | 52.6 |
| NL2Repo | 27.3 | 15.5 | 20.5 | 11.6 | 29.4 |
| QwenWebBench | 1068 | 1197 | 978 | 1178 | 1397 |
| 通用智能体 | |||||
| TAU3-Bench | 68.4 | 67.5 | 68.9 | 59.0 | 67.2 |
| VITA-Bench | 41.8 | 43.0 | 29.1 | 36.9 | 35.6 |
| DeepPlanning | 22.6 | 24.0 | 22.8 | 16.2 | 25.9 |
| Tool Decathlon | 31.5 | 21.2 | 28.7 | 12.0 | 26.9 |
| MCPMark | 36.3 | 18.1 | 27.0 | 14.2 | 37.0 |
| MCP-Atlas | 68.4 | 57.2 | 62.4 | 50.0 | 62.8 |
| WideSearch | 66.4 | 35.2 | 59.1 | 38.3 | 60.1 |
| 知识 | |||||
| MMLU-Pro | 86.1 | 85.2 | 85.3 | 82.6 | 85.2 |
| MMLU-Redux | 93.2 | 93.7 | 93.3 | 92.7 | 93.3 |
| SuperGPQA | 65.6 | 65.7 | 63.4 | 61.4 | 64.7 |
| C-Eval | 90.5 | 82.6 | 90.2 | 82.5 | 90.0 |
| STEM 与推理 | |||||
| GPQA | 85.5 | 84.3 | 84.2 | 82.3 | 86.0 |
| HLE | 24.3 | 19.5 | 22.4 | 8.7 | 21.4 |
| LiveCodeBench v6 | 80.7 | 80.0 | 74.6 | 77.1 | 80.4 |
| HMMT Feb 25 | 92.0 | 88.7 | 89.0 | 91.7 | 90.7 |
| HMMT Nov 25 | 89.8 | 87.5 | 89.2 | 87.5 | 89.1 |
| HMMT Feb 26 | 84.3 | 77.2 | 78.7 | 79.0 | 83.6 |
| IMOAnswerBench | 79.9 | 74.5 | 76.8 | 74.3 | 78.9 |
| AIME26 | 92.6 | 89.2 | 91.0 | 88.3 | 92.7 |
* SWE-Bench 系列:内部 agent scaffold(bash + 文件编辑工具);temp=1.0,top_p=0.95,200K 上下文窗口。我们修正了 SWE-bench Pro 公开集中的一些有问题任务,并在改进后的基准上评估所有基线。
* Terminal-Bench 2.0:Harbor/Terminus-2 harness;3 小时超时,32 CPU/48 GB RAM;temp=1.0,top_p=0.95,top_k=20,max_tokens=80K,256K ctx;5 次运行平均值。
* SkillsBench:通过 OpenCode 在 78 个任务上评估(自包含子集,排除依赖 API 的任务);5 次运行平均值。
* NL2Repo:其他通过 Claude Code 评估(temp=1.0,top_p=0.95,max_turns=900)。
* QwenClawBench:内部真实用户分布 Claw agent 基准(即将开源);temp=0.6,256K ctx。
* QwenWebBench:内部前端代码生成基准;双语(EN/CN),7 个类别(网页设计、Web 应用、游戏、SVG、数据可视化、动画和 3D);自动渲染 + 多模态评判(代码/视觉正确性);BT/Elo 评分系统。
* TAU3-Bench:我们使用官方用户模型(gpt-5.2,低推理努力)+ 默认 BM25 检索。
* VITA-Bench:子域平均分;使用 claude-4-sonnet 作为评判器,因为官方评判器(claude-3.7-sonnet)已不可用。
* MCPMark:GitHub MCP v0.30.3;Playwright 响应截断至 32K tokens。
* MCP-Atlas:公开集分数;gemini-2.5-pro 评判器。
* AIME 26:我们使用完整的 AIME 2026(I & II),分数可能与 Qwen 3.5 说明不同。
视觉语言
| Qwen3.5-27B | Claude-Sonnet-4.5 | Gemma4-31B | Gemma4-26BA4B | Qwen3.5-35B-A3B | Qwen3.6-35B-A3B | |
|---|---|---|---|---|---|---|
| STEM 与谜题 | ||||||
| MMMU | 82.3 | 79.6 | 80.4 | 78.4 | 81.4 | 81.7 |
| MMMU-Pro | 75.0 | 68.4 | 76.9* | 73.8* | 75.1 | 75.3 |
| Mathvista(mini) | 87.8 | 79.8 | 79.3 | 79.4 | 86.2 | 86.4 |
| ZEROBench_sub | 36.2 | 26.3 | 26.0 | 26.3 | 34.1 | 34.4 |
| 通用 VQA | ||||||
| RealWorldQA | 83.7 | 70.3 | 72.3 | 72.2 | 84.1 | 85.3 |
| MMBenchEN-DEV-v1.1 | 92.6 | 88.3 | 90.9 | 89.0 | 91.5 | 92.8 |
| SimpleVQA | 56.0 | 57.6 | 52.9 | 52.2 | 58.3 | 58.9 |
| HallusionBench | 70.0 | 59.9 | 67.4 | 66.1 | 67.9 | 69.8 |
| 文本识别与文档理解 | ||||||
| OmniDocBench1.5 | 88.9 | 85.8 | 80.1 | 74.4 | 89.3 | 89.9 |
| CharXiv(RQ) | 79.5 | 67.2 | 67.9 | 69.0 | 77.5 | 78.0 |
| CC-OCR | 81.0 | 68.1 | 75.7 | 74.5 | 80.7 | 81.9 |
| AI2D_TEST | 92.9 | 87.0 | 89.0 | 88.3 | 92.6 | 92.7 |
| 空间智能 | ||||||
| RefCOCO(avg) | 90.9 | -- | -- | -- | 89.2 | 92.0 |
| ODInW13 | 41.1 | -- | -- | -- | 42.6 | 50.8 |
| EmbSpatialBench | 84.5 | 71.8 | -- | -- | 83.1 | 84.3 |
| RefSpatialBench | 67.7 | -- | -- | -- | 63.5 | 64.3 |
| 视频理解 | ||||||
| VideoMME(w sub.) | 87.0 | 81.1 | -- | -- | 86.6 | 86.6 |
| VideoMME(w/o sub.) | 82.8 | 75.3 | -- | -- | 82.5 | 82.5 |
| VideoMMMU | 82.3 | 77.6 | 81.6 | 76.0 | 80.4 | 83.7 |
| MLVU | 85.9 | 72.8 | -- | -- | 85.6 | 86.2 |
| MVBench | 74.6 | -- | -- | -- | 74.8 | 74.6 |
| LVBench | 73.6 | -- | -- | -- | 71.4 | 71.4 |
* 空白单元格(--)表示分数不可用或不适用。
快速开始
为简化集成,我们建议通过 API 使用 Qwen3.6。以下是使用 OpenAI 兼容 API 调用 Qwen3.6 的指南。
部署 Qwen3.6
Qwen3.6 可通过主流推理框架以 API 方式部署。 下面我们展示为 Qwen3.6 模型启动 OpenAI 兼容 API 服务器的示例命令。
不同框架的推理效率和吞吐量差异显著。 我们建议使用最新的框架版本,以确保最佳性能和兼容性。 对于生产工作负载或高吞吐场景,强烈推荐使用 SGLang、KTransformers 或 vLLM 等专用服务引擎。
该模型默认上下文长度为 262,144 tokens。 如果遇到内存不足(OOM)错误,请考虑减小上下文窗口。 但是,由于 Qwen3.6 利用扩展上下文处理复杂任务,我们建议保持至少 128K tokens 的上下文长度,以保留思考能力。
SGLang
SGLang 是面向大语言模型和视觉语言模型的快速服务框架。
Qwen3.6 推荐使用 sglang>=0.5.10,可在全新环境中使用以下命令安装:
uv pip install sglang[all]
更多详情请参阅其文档。
以下命令将在 http://localhost:8000/v1 创建 API 端点:
标准版本:可使用以下命令,在 8 个 GPU 上通过张量并行创建一个最大上下文长度为 262,144 tokens 的 API 端点。
python -m sglang.launch_server --model-path Qwen/Qwen3.6-35B-A3B --port 8000 --tp-size 8 --mem-fraction-static 0.8 --context-length 262144 --reasoning-parser qwen3工具使用:要支持工具使用,可使用以下命令。
python -m sglang.launch_server --model-path Qwen/Qwen3.6-35B-A3B --port 8000 --tp-size 8 --mem-fraction-static 0.8 --context-length 262144 --reasoning-parser qwen3 --tool-call-parser qwen3_coder多 Token 预测(MTP):MTP 推荐使用以下命令:
python -m sglang.launch_server --model-path Qwen/Qwen3.6-35B-A3B --port 8000 --tp-size 8 --mem-fraction-static 0.8 --context-length 262144 --reasoning-parser qwen3 --speculative-algo NEXTN --speculative-num-steps 3 --speculative-eagle-topk 1 --speculative-num-draft-tokens 4
详细部署指南,请参阅 SGLang Qwen3.5 Cookbook。
vLLM
vLLM 是一个面向 LLM 的高吞吐、内存高效的推理与服务引擎。
Qwen3.6 推荐使用 vllm>=0.19.0,可在全新环境中使用以下命令安装:
uv pip install vllm --torch-backend=auto
更多详情请参阅 其文档。
以下操作将在 http://localhost:8000/v1 创建 API 端点:
标准版本:可使用以下命令,在 8 个 GPU 上通过张量并行创建一个最大上下文长度为 262,144 tokens 的 API 端点。
vllm serve Qwen/Qwen3.6-35B-A3B --port 8000 --tensor-parallel-size 8 --max-model-len 262144 --reasoning-parser qwen3工具调用:要支持工具使用,可使用以下命令。
vllm serve Qwen/Qwen3.6-35B-A3B --port 8000 --tensor-parallel-size 8 --max-model-len 262144 --reasoning-parser qwen3 --enable-auto-tool-choice --tool-call-parser qwen3_coder多 Token 预测(MTP):MTP 推荐使用以下命令:
vllm serve Qwen/Qwen3.6-35B-A3B --port 8000 --tensor-parallel-size 8 --max-model-len 262144 --reasoning-parser qwen3 --speculative-config '{"method":"qwen3_next_mtp","num_speculative_tokens":2}'纯文本:以下命令会跳过视觉编码器和多模态性能分析,以释放内存用于额外的 KV 缓存:
vllm serve Qwen/Qwen3.6-35B-A3B --port 8000 --tensor-parallel-size 8 --max-model-len 262144 --reasoning-parser qwen3 --language-model-only
详细部署指南,请参阅 vLLM Qwen3.5 Recipe。
KTransformers
KTransformers 是一个灵活的框架,可通过 CPU-GPU 异构计算体验前沿的 LLM 推理优化。 要使用 KTransformers 运行 Qwen3.6,请参阅 KTransformers 部署指南。
HF Mirror Transformers
HF Mirror Transformers 包含一个轻量级服务器,可用于快速测试和中等负载部署。
Qwen3.6 需要最新的 transformers:
pip install "transformers[serving]"
更多详情请参阅 其文档。另请确保已安装 torchvision 和 pillow。
然后运行 transformers serve 启动服务器,API 端点位于 http://localhost:8000/v1;如果可用,它会将模型放置在加速器上:
transformers serve Qwen/Qwen3.6-35B-A3B --port 8000 --continuous-batching
通过 Chat Completions API 使用 Qwen3.6
Chat Completions API 可通过标准 HTTP 请求或 OpenAI SDK 访问。 这里我们展示使用 OpenAI Python SDK 的示例。
开始之前,请确保已安装它,并已配置 API key 和 API base URL,例如:
pip install -U openai

# Set the following accordingly
export OPENAI_BASE_URL="http://localhost:8000/v1"
export OPENAI_API_KEY="EMPTY"
我们推荐使用以下采样参数进行生成
- 通用任务的思考模式:
temperature=1.0, top_p=0.95, top_k=20, min_p=0.0, presence_penalty=1.5, repetition_penalty=1.0- 精确编码任务(例如 WebDev)的思考模式:
temperature=0.6, top_p=0.95, top_k=20, min_p=0.0, presence_penalty=0.0, repetition_penalty=1.0- 指令(或非思考)模式:
temperature=0.7, top_p=0.80, top_k=20, min_p=0.0, presence_penalty=1.5, repetition_penalty=1.0请注意,对采样参数的支持因推理框架而异。
Qwen3.6 模型默认以思考模式运行,在生成最终回复之前会生成由
<think>\n...</think>\n\n表示的思考内容。 要禁用思考内容并获得直接回复,请参阅此处的示例。
纯文本输入
from openai import OpenAI
# Configured by environment variables
client = OpenAI()

messages = [
    {"role": "user", "content": "Type \"I love Qwen3.6\" backwards"},
]

chat_response = client.chat.completions.create(
    model="Qwen/Qwen3.6-35B-A3B",
    messages=messages,
    max_tokens=81920,
    temperature=1.0,
    top_p=0.95,
    presence_penalty=1.5,
    extra_body={
        "top_k": 20,
    },
)
print("Chat response:", chat_response)
图像输入
from openai import OpenAI
# Configured by environment variables
client = OpenAI()

messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "image_url",
                "image_url": {
                    "url": "https://qianwen-res.oss-accelerate.aliyuncs.com/Qwen3.5/demo/CI_Demo/mathv-1327.jpg"
                }
            },
            {
                "type": "text",
                "text": "The centres of the four illustrated circles are in the corners of the square. The two big circles touch each other and also the two little circles. With which factor do you have to multiply the radii of the little circles to obtain the radius of the big circles?\nChoices:\n(A) $\\frac{2}{9}$\n(B) $\\sqrt{5}$\n(C) $0.8 \\cdot \\pi$\n(D) 2.5\n(E) $1+\\sqrt{2}$"
            }
        ]
    }
]

chat_response = client.chat.completions.create(
    model="Qwen/Qwen3.6-35B-A3B",
    messages=messages,
    max_tokens=81920,
    temperature=1.0,
    top_p=0.95,
    presence_penalty=1.5,
    extra_body={
        "top_k": 20,
    },
)
print("Chat response:", chat_response)
视频输入
from openai import OpenAI
# Configured by environment variables
client = OpenAI()

messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "video_url",
                "video_url": {
                    "url": "https://qianwen-res.oss-accelerate.aliyuncs.com/Qwen3.5/demo/video/N1cdUjctpG8.mp4"
                }
            },
            {
                "type": "text",
                "text": "How many porcelain jars were discovered in the niches located in the primary chamber of the tomb?"
            }
        ]
    }
]

# When vLLM is launched with `--media-io-kwargs '{"video": {"num_frames": -1}}'`,
# video frame sampling can be configured via `extra_body` (e.g., by setting `fps`).
# This feature is currently supported only in vLLM.
#
# By default, `fps=2` and `do_sample_frames=True`.
# With `do_sample_frames=True`, you can customize the `fps` value to set your desired video sampling rate.
chat_response = client.chat.completions.create(
    model="Qwen/Qwen3.6-35B-A3B",
    messages=messages,
    max_tokens=81920,
    temperature=1.0,
    top_p=0.95,
    presence_penalty=1.5,
    extra_body={
        "top_k": 20,
        "mm_processor_kwargs": {"fps": 2, "do_sample_frames": True},
    },
)

print("Chat response:", chat_response)
指令(或非思考)模式
Qwen3.6 不正式支持 Qwen3 的软开关,即
/think和/nothink。
Qwen3.6 在回复前默认会进行思考。 你可以通过配置 API 参数,获得模型不进行思考的直接回复。 例如,
from openai import OpenAI
# Configured by environment variables
client = OpenAI()

messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "image_url",
                "image_url": {
                    "url": "https://qianwen-res.oss-accelerate.aliyuncs.com/Qwen3.6/demo/RealWorld/RealWorld-04.png"
                }
            },
            {
                "type": "text",
                "text": "Where is this?"
            }
        ]
    }
]

chat_response = client.chat.completions.create(
    model="Qwen/Qwen3.6-35B-A3B",
    messages=messages,
    max_tokens=32768,
    temperature=0.7,
    top_p=0.8,
    presence_penalty=1.5,
    extra_body={
        "top_k": 20,
        "chat_template_kwargs": {"enable_thinking": False},
    },
)
print("Chat response:", chat_response)
如果你使用的是阿里云百炼的 API,除了更改
model之外,请使用"enable_thinking": False而不是"chat_template_kwargs": {"enable_thinking": False}。
保留思考内容
默认情况下,仅保留处理最新用户消息时生成的思考块,从而形成通常所说的交错思考模式。
Qwen3.6 经过额外训练,能够保留并利用历史消息中的思考轨迹。
你可以通过设置 preserve_thinking 选项来启用此行为:
from openai import OpenAI
# Configured by environment variables
client = OpenAI()

messages = [...]

chat_response = client.chat.completions.create(
    model="Qwen/Qwen3.6-35B-A3B",
    messages=messages,
    max_tokens=32768,
    temperature=0.7,
    top_p=0.8,
    presence_penalty=1.5,
    extra_body={
        "top_k": 20,
        "chat_template_kwargs": {"preserve_thinking": True},
    },
)
print("Chat response:", chat_response)
如果你使用的是阿里云百炼的 API,除了修改
model之外,请使用"preserve_thinking": True而不是"chat_template_kwargs": {"preserve_thinking": False}。
这一能力对智能体场景尤为有益,在此类场景中,保持完整的推理上下文可以增强决策一致性,并且在许多情况下,通过减少冗余推理来降低整体 token 消耗。此外,它还能提升 KV 缓存利用率,优化思考模式与非思考模式下的推理效率。
智能体使用
Qwen3.6 在工具调用能力方面表现出色。
Qwen-Agent
我们推荐使用 Qwen-Agent 快速构建基于 Qwen3.6 的 Agent 应用。
要定义可用的工具,你可以使用 MCP 配置文件、使用 Qwen-Agent 的集成工具,或自行集成其他工具。
import os
from qwen_agent.agents import Assistant

# Define LLM
# Using Alibaba Cloud Model Studio
llm_cfg = {
    # Use the OpenAI-compatible model service provided by DashScope:
    'model': 'Qwen3.6-35B-A3B',
    'model_type': 'qwenvl_oai',
    'model_server': 'https://dashscope.aliyuncs.com/compatible-mode/v1',
    'api_key': os.getenv('DASHSCOPE_API_KEY'),

    'generate_cfg': {
        'use_raw_api': True,
        # When using Dash Scope OAI API, pass the parameter of whether to enable thinking mode in this way
        'extra_body': {
            'enable_thinking': True,
            'preserve_thinking': True,
        },
    },
}

# Using OpenAI-compatible API endpoint.
# functionality of the deployment frameworks and let Qwen-Agent automate the related operations.
#
# llm_cfg = {
#     # Use your own model service compatible with OpenAI API by vLLM/SGLang:
#     'model': 'Qwen/Qwen3.6-35B-A3B',
#     'model_type': 'qwenvl_oai',
#     'model_server': 'http://localhost:8000/v1',  # api_base
#     'api_key': 'EMPTY',
#
#     'generate_cfg': {
#         'use_raw_api': True,
#         # When using vLLM/SGLang OAI API, pass the parameter of whether to enable thinking mode in this way
#         'extra_body': {
#             'chat_template_kwargs': {'enable_thinking': True, 'preserve_thinking': True}
#         },
#     },
# }

# Define Tools
tools = [
    {'mcpServers': {  # You can specify the MCP configuration file
            "filesystem": {
                "command": "npx",
                "args": ["-y", "@modelcontextprotocol/server-filesystem", "/Users/xxxx/Desktop"]
            }
        }
    }
]

# Define Agent
bot = Assistant(llm=llm_cfg, function_list=tools)

# Streaming generation
messages = [{'role': 'user', 'content': 'Help me organize my desktop.'}]
for responses in bot.run(messages=messages):
    pass
print(responses)

# Streaming generation
messages = [{'role': 'user', 'content': 'Develop a dog website and save it on the desktop'}]
for responses in bot.run(messages=messages):
    pass
print(responses)
Qwen Code
Qwen Code 是一个面向终端的开源 AI 智能体,针对 Qwen 模型进行了优化。它可以帮助你理解大型代码库、自动化繁琐工作,并加快交付速度。
更多信息请参阅 Qwen Code。
处理超长文本
Qwen3.6 原生支持最长 262,144 个 token 的上下文长度。 对于总长度(包括输入和输出)超过此限制的长程任务,我们建议使用 RoPE 缩放技术来有效处理长文本,例如 YaRN。
目前已有多个推理框架支持 YaRN,例如 transformers、vllm、ktransformers 和 sglang。
一般来说,在受支持的框架中启用 YaRN 有两种方式:
修改模型配置文件: 在
config.json文件中,将text_config中的rope_parameters字段改为:{ "mrope_interleaved": true, "mrope_section": [ 11, 11, 10 ], "rope_type": "yarn", "rope_theta": 10000000, "partial_rotary_factor": 0.25, "factor": 4.0, "original_max_position_embeddings": 262144, }通过命令行参数传入:
对于
vllm,你可以使用VLLM_ALLOW_LONG_MAX_MODEL_LEN=1 vllm serve ... --hf-overrides '{"text_config": {"rope_parameters": {"mrope_interleaved": true, "mrope_section": [11, 11, 10], "rope_type": "yarn", "rope_theta": 10000000, "partial_rotary_factor": 0.25, "factor": 4.0, "original_max_position_embeddings": 262144}}}' --max-model-len 1010000对于
sglang和ktransformers,你可以使用SGLANG_ALLOW_OVERWRITE_LONGER_CONTEXT_LEN=1 python -m sglang.launch_server ... --json-model-override-args '{"text_config": {"rope_parameters": {"mrope_interleaved": true, "mrope_section": [11, 11, 10], "rope_type": "yarn", "rope_theta": 10000000, "partial_rotary_factor": 0.25, "factor": 4.0, "original_max_position_embeddings": 262144}}}' --context-length 1010000
所有知名的开源框架实现的都是静态 YaRN,这意味着缩放因子不随输入长度变化,可能会影响较短文本上的性能。 我们建议仅在需要处理长上下文时才修改
rope_parameters配置。 同时建议根据需要修改factor。例如,如果你的应用典型上下文长度为 524,288 个 token,最好将factor设为 2.0。
最佳实践
为获得最佳性能,我们推荐以下设置:
采样参数:
- We suggest using the following sets of sampling parameters depending on the mode and task type:
- 通用任务的思考模式:
temperature=1.0、top_p=0.95、top_k=20、min_p=0.0、presence_penalty=1.5、repetition_penalty=1.0 - 精确编码任务(例如 WebDev)的思考模式:
temperature=0.6、top_p=0.95、top_k=20、min_p=0.0、presence_penalty=0.0、repetition_penalty=1.0 - Instruct(或非思考)模式:
temperature=0.7、top_p=0.80、top_k=20、min_p=0.0、presence_penalty=1.5、repetition_penalty=1.0
- 通用任务的思考模式:
- 对于受支持的框架,你可以在 0 到 2 之间调整
presence_penalty参数以减少无休止的重复。不过,使用较高的值有时可能导致语言混杂以及模型性能略有下降。
- We suggest using the following sets of sampling parameters depending on the mode and task type:
足够的输出长度:对于大多数查询,我们建议使用 32,768 个 token 的输出长度。对于数学和编程竞赛等高度复杂问题的基准测试,我们建议将最大输出长度设置为 81,920 个 token。这为模型提供了充足的空间来生成详细且全面的回答,从而提升其整体表现。
标准化输出格式:我们建议在进行基准测试时使用提示词来标准化模型输出。
- 数学问题:在提示词中加入“Please reason step by step, and put your final answer within \boxed{}.”。
- 多项选择题:在提示词中加入以下 JSON 结构以标准化回答:“Please show your choice in the
answerfield with only the choice letter, e.g.,"answer": "C".”。
长视频理解:为优化纯文本和图像的推理效率,已发布版本
video_preprocessor_config.json中的size参数采用了保守配置。建议将 video_preprocessor_config 文件中的longest_edge参数设置为 469,762,048(对应 224k 视频 token),以便对小时级视频启用更高帧率采样,从而获得更优性能。例如,{"longest_edge": 469762048, "shortest_edge": 4096}
引用
如果您觉得我们的工作有帮助,欢迎引用我们。
@misc{qwen36_35b_a3b,
    title = {{Qwen3.6-35B-A3B}: Agentic Coding Power, Now Open to All},
    url = {https://qwen.ai/blog?id=qwen3.6-35b-a3b},
    author = {{Qwen Team}},
    month = {April},
    year = {2026}
}
来源:Qwen 模型发布 · hf-mirror.com