面壁开源 MiniCPM-V 4.7 35B-A3B,首个可在端侧流畅运行的 MoE 多模态模型
openbmb/MiniCPM-V-4.7-35B-A3B
面壁发布 MiniCPM-V 4.7,其中 35B-A3B 是 MiniCPM-V 系列首个 MoE 模型,官方称其为首个不牺牲性能即可在端侧流畅运行的开源 MoE 模型,在 iPhone 17 Pro Max 上仅用 3 GB 内存实现 13+ tokens/s 解码速度。
面壁开源 MiniCPM-V 4.7 的 35B-A3B MoE 变体,给出端侧推理速度与内存占用数据,可对照其与 Qwen3.6 的效率差异。
GitHub · 端侧结果 · 评估 · 示例 · 使用 · 模型权重 · DSpark
MiniCPM-V 4.7 是 MiniCPM-V 系列的最新模型,提供 35B-A3B 变体,其中 35B-A3B 是 MiniCPM-V 系列首个 MoE 模型。它延续了该系列的单图、多图和视频理解能力,将更强的基础能力与高效视觉编码和端侧推理相结合。MiniCPM-V 4.7 的显著特性包括:
- 📱 首个实现无损、流畅端侧推理的开源 MoE 模型。 借助随 MiniCPM-V 4.7 一同推出的 Lookahead Expert Scheduling (LES) 技术,结合细粒度逐层量化和 DSpark 投机采样集成,MiniCPM-V 4.7 35B-A3B 成为首个在不牺牲性能的前提下于端侧流畅运行的开源 MoE 模型,在 iPhone 17 Pro Max 上仅需 3 GB 内存即可达到 13+ tokens/s 的解码速度。
- 🔥 性能与效率的新帕累托前沿。 随着模型能力不断提升,推理效率已成为衡量模型价值的重要指标。在资源受限的设备上,要在有限的资源预算内提供尽可能强的能力,就需要更高的能力密度。MiniCPM-V 4.7 的 35B-A3B 变体推进了 MLLM 的性能–效率帕累托前沿。在 Instruct 模式下,35B-A3B 以更少的推理时间取得了比 Qwen3.6 35B-A3B 更高的总体得分。
- 🚀 高效架构。 基于 LLaVA-UHD v4 的 ViT 内部早期压缩技术,MiniCPM-V 4.7 在视觉编码器内部提前压缩视觉 token,从而减少后续编码器层的计算量。它还支持4x/16x 混合视觉 token 压缩,让开发者可以针对不同任务在视觉细节和推理成本之间取得平衡。
- 💻 广泛的平台与芯片支持。 MiniCPM-V 4.7 支持 iOS、Android 和 HarmonyOS,并提供开源的端侧部署支持。它还首日支持 Rockchip、Houmo、Intel、AMD 和 Arm 的芯片平台,将部署选项扩展到移动设备和本地计算设备。
- 🛠️ 对开发者友好。 MiniCPM-V 4.7 支持包括 SGLang、vLLM、llama.cpp 和 Ollama 在内的推理框架,以及包括 SWIFT 和 LLaMA-Factory 在内的微调框架。它提供 GGUF、BNB、AWQ 和 GPTQ 量化变体,并新增 FP8 量化支持。我们还发布了 Self-Replay Fine-Tuning (SRFT),这是一种微调方法,可帮助开发者以低成本扩展模型能力,同时减少对已有能力的遗忘,使进一步定制更加容易。
开始使用
模型权重 · 推理 · 微调 · 在线演示 · 本地部署 · API · Cookbook
端侧能力与效率
在不牺牲性能的前提下实现流畅的端侧 MoE 推理
MoE 模型的总参数量可能远多于单个 token 所激活的参数量,但其端侧存储需求并不局限于这些激活参数。不同 token 在不同层可能选择不同的专家,而设备内存往往无法容纳全部专家权重。在没有延迟约束的情况下,权重可以保留在 SSD 或其他存储中,按需加载,并在计算完成后释放。这使得大模型推理成为可能,但反复加载造成的停顿会使解码速度过慢,无法满足实时交互需求。
另一种方法是限制可用专家的范围。例如,为整个 prompt 固定一个专家子集可以降低加载频率,但会将后续的 token 级路由限制在该子集内,可能排除模型原本会选择的专家,从而削弱其能力。因此,核心目标是在不牺牲性能的前提下实现流畅推理:在有限的内存和带宽下,既保持模型能力,又提供足够的吞吐量。
MiniCPM-V 4.7 35B-A3B 通过三项互补技术应对这一挑战:
- 前瞻专家调度(LES)利用跨层路由预测,预加载下一层可能需要的专家。在实际路由器选出的专家中,它优先处理已成功预取的专家,并将其计算与其余所需专家的加载过程重叠。预测仅用于指导预取和调度;计算仍遵循模型原始的 token 级路由,预测未命中的所需专家会照常加载并评估。
- 细粒度逐层量化在保持模型能力的同时,降低专家权重的存储占用和内存流量,使专家加载更好地适应端侧内存和带宽约束。
- DSpark 投机采样集成将投机采样引入端侧推理流程,与专家调度和量化协同工作,提升解码效率。
这些技术共同使 MiniCPM-V 4.7 35B-A3B 成为首个在不牺牲性能的前提下于端侧流畅运行的开源 MoE 模型,在 iPhone 17 Pro Max 上达到 13+ tokens/s。
端侧 MoE 推理:优化前后对比
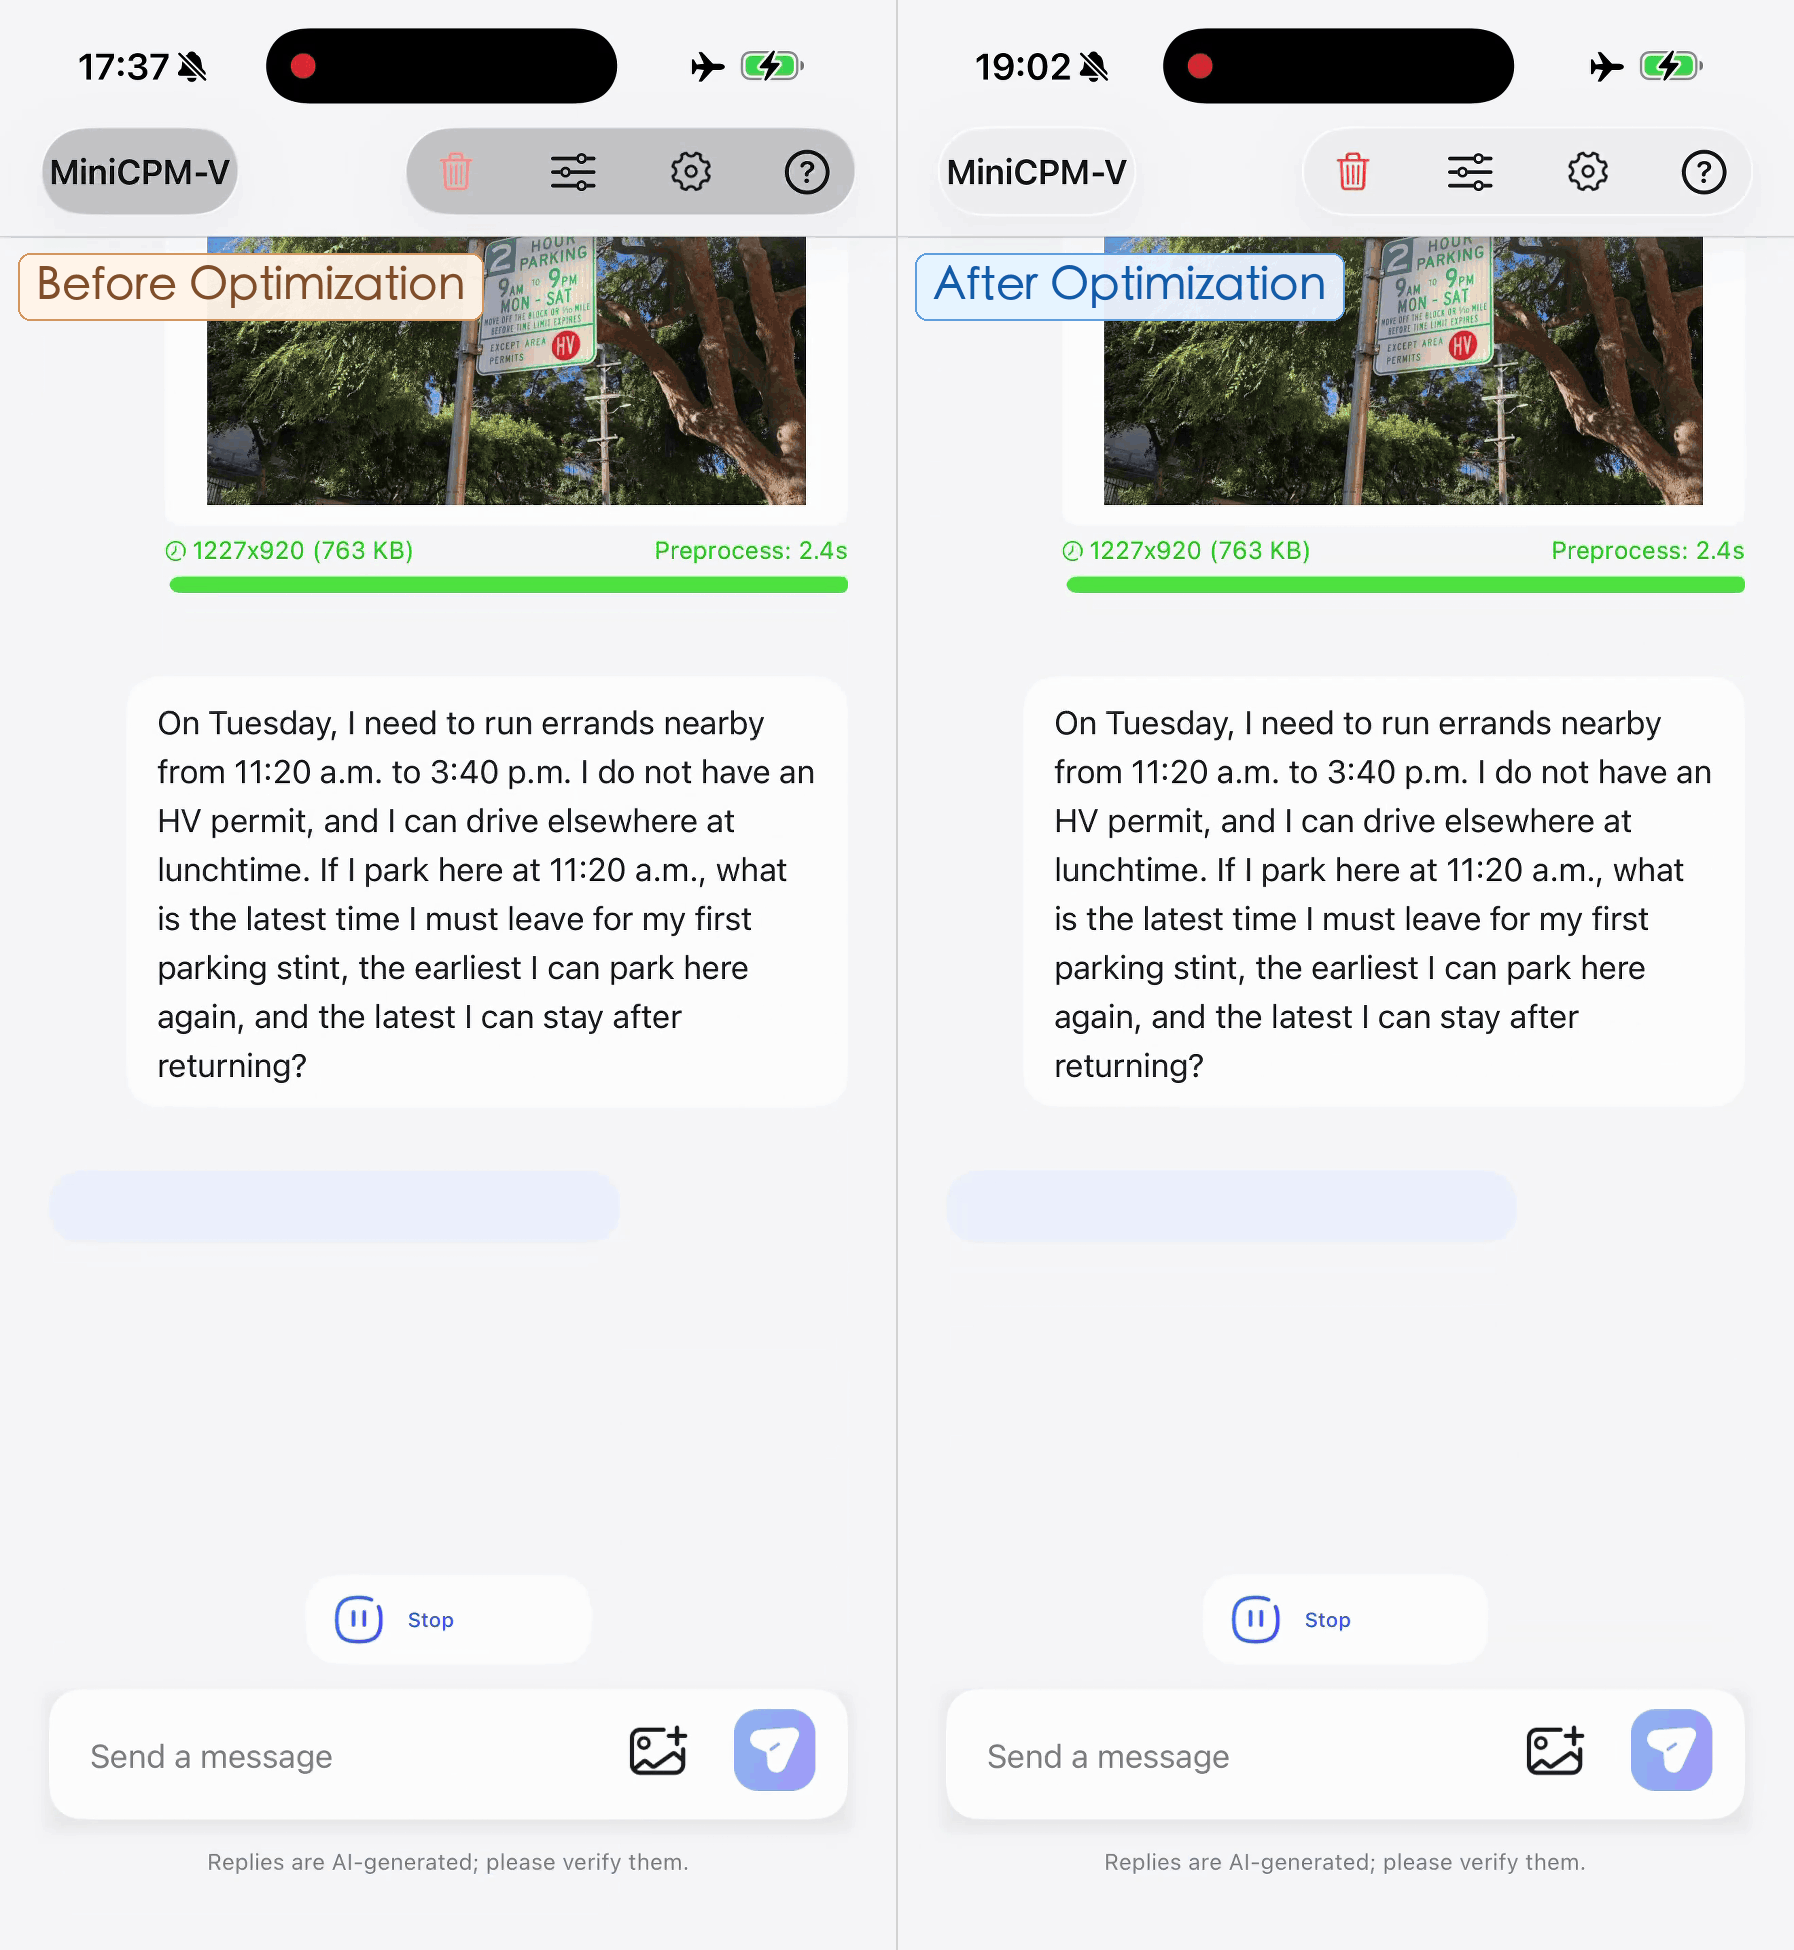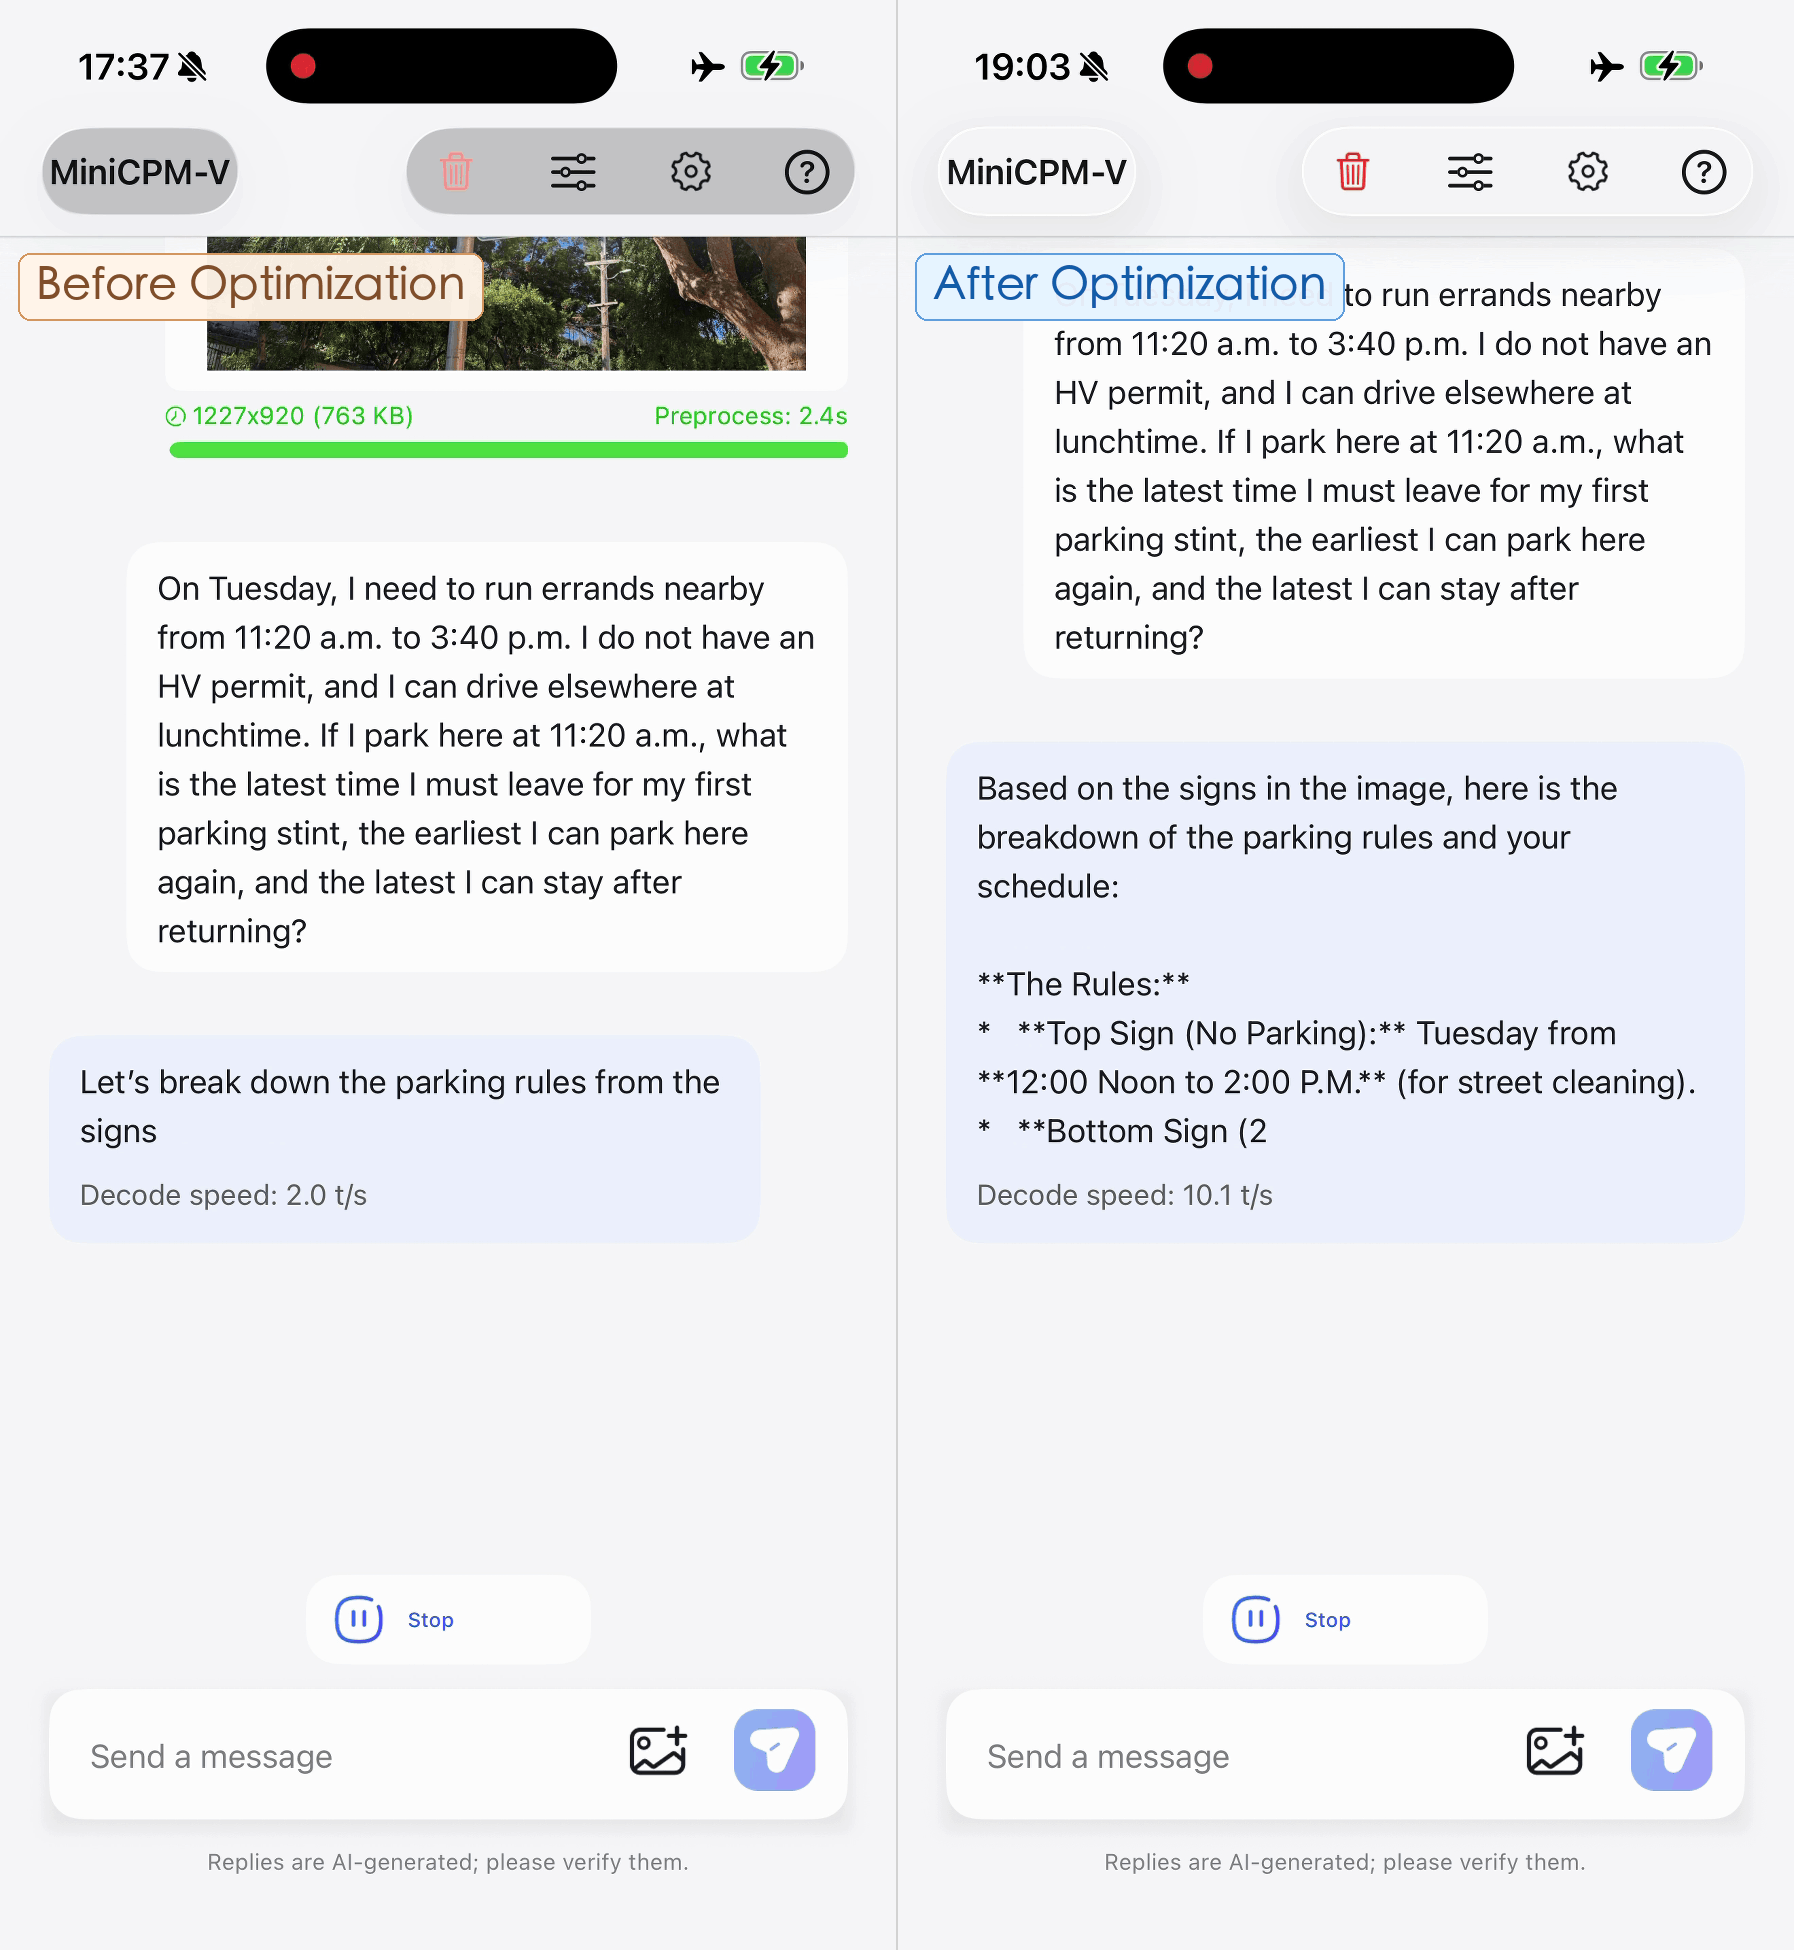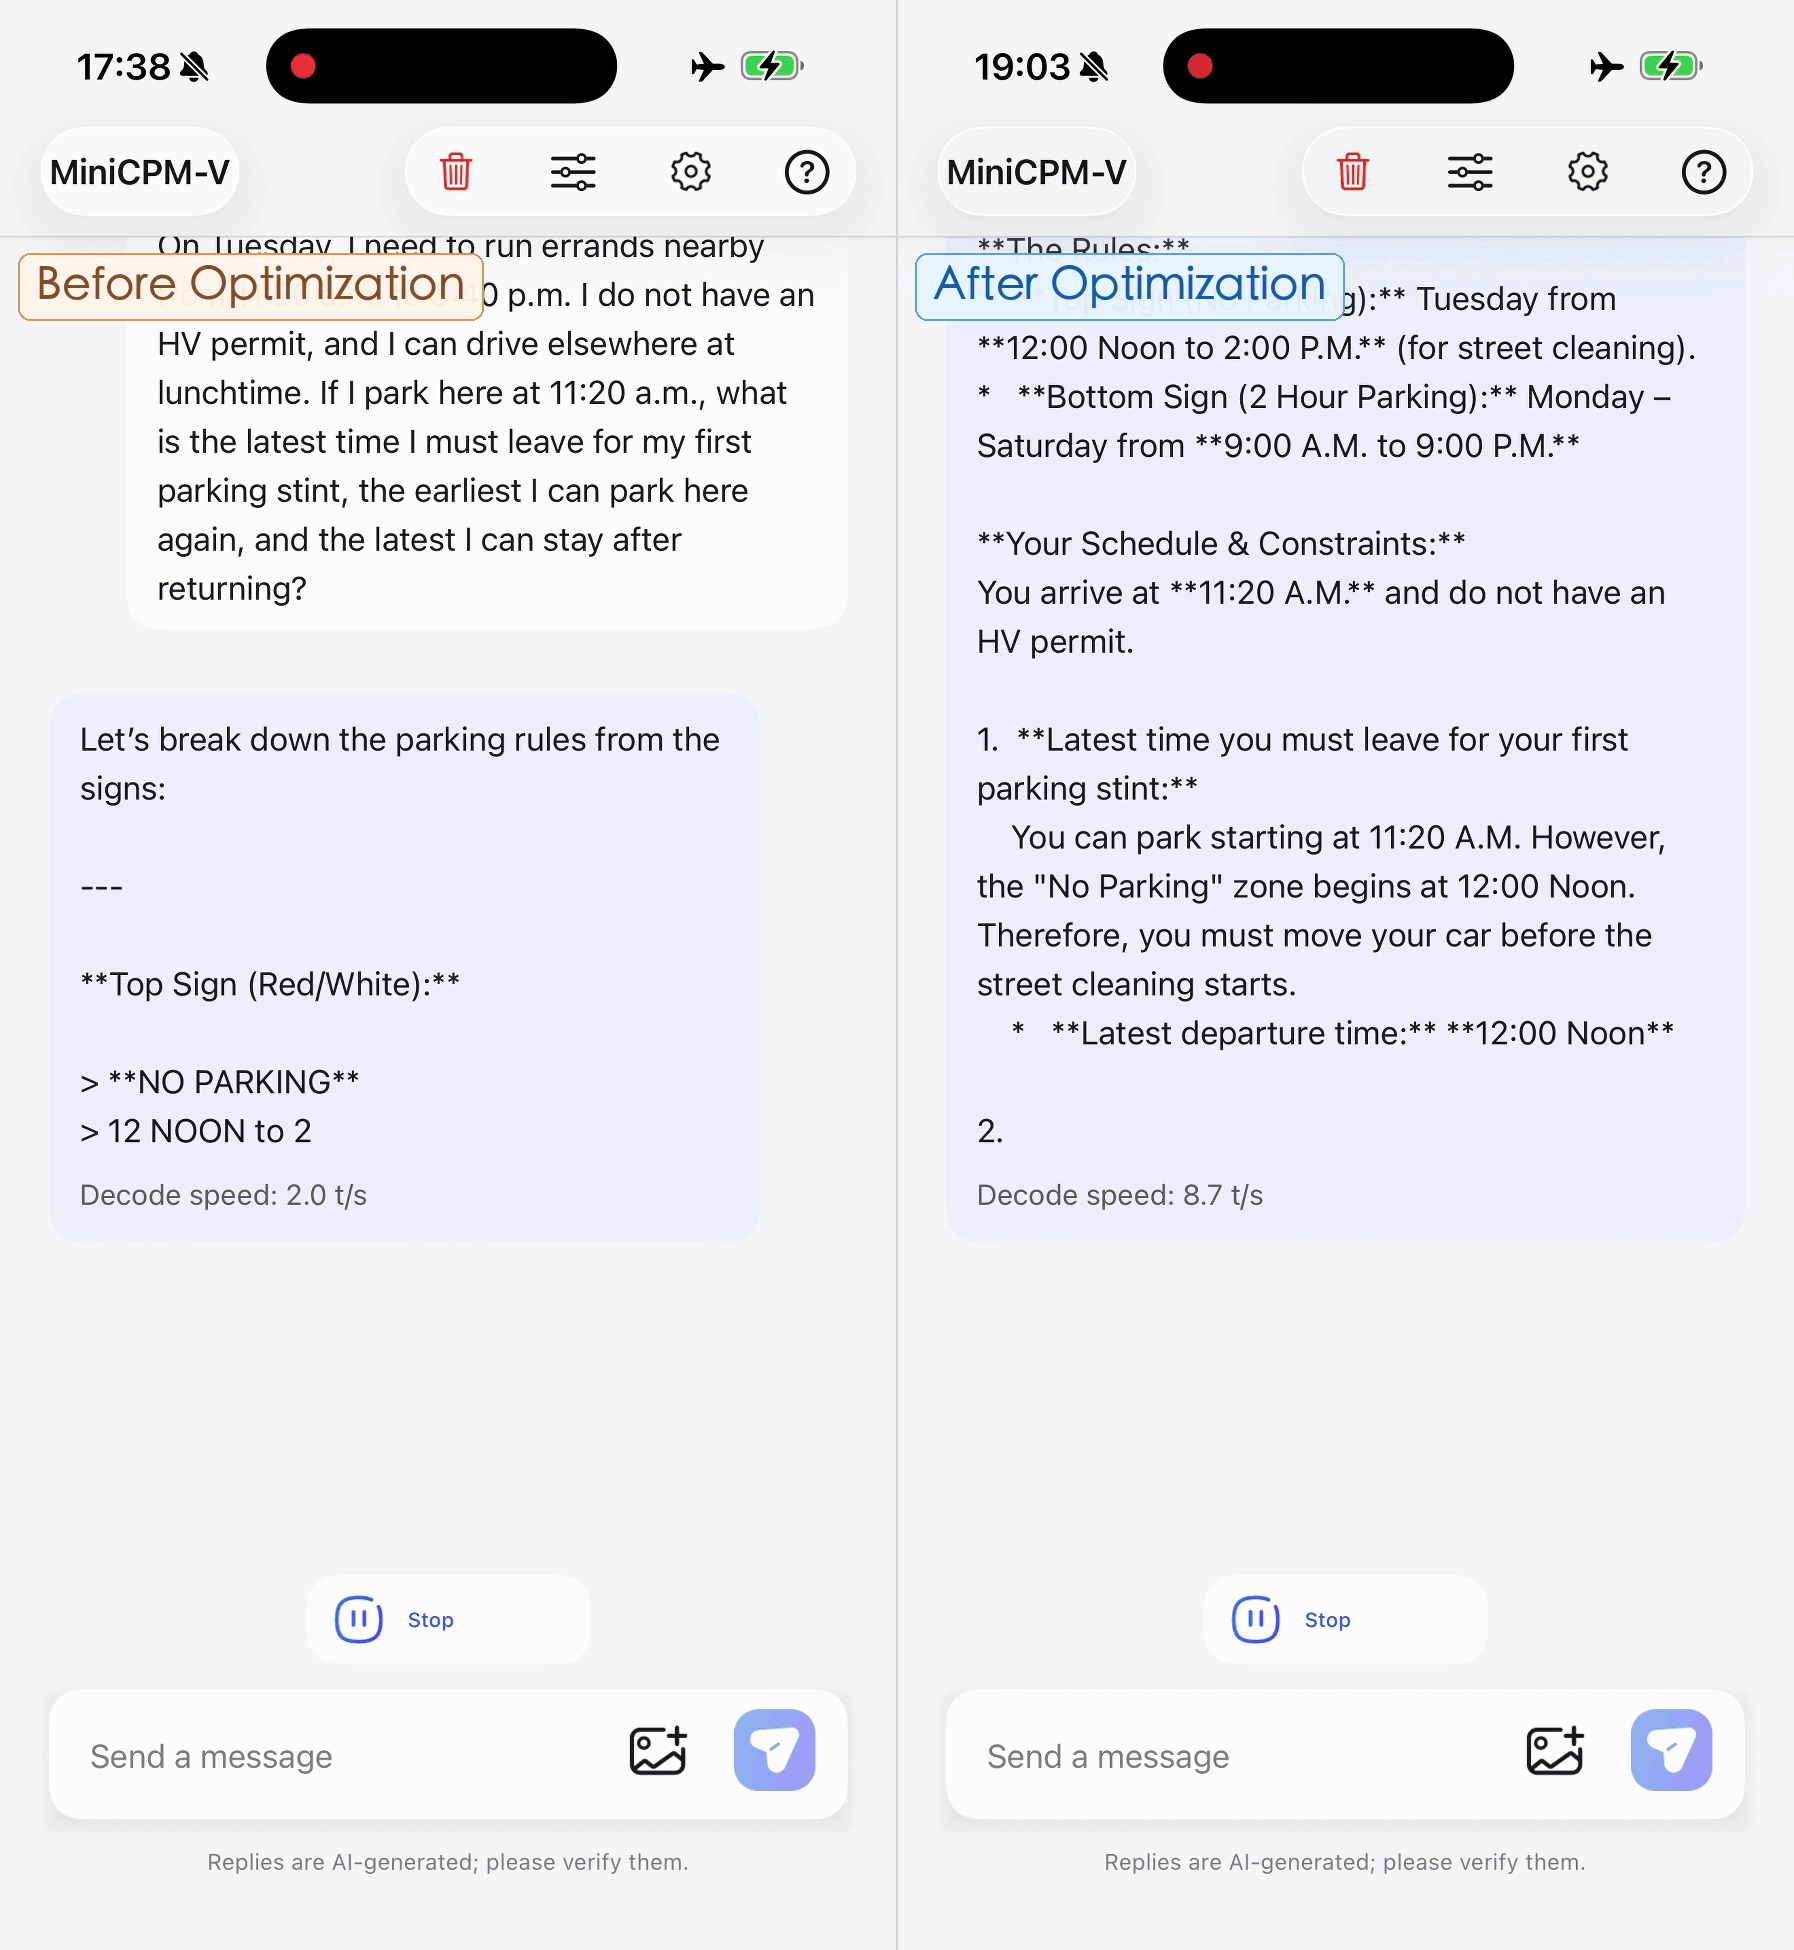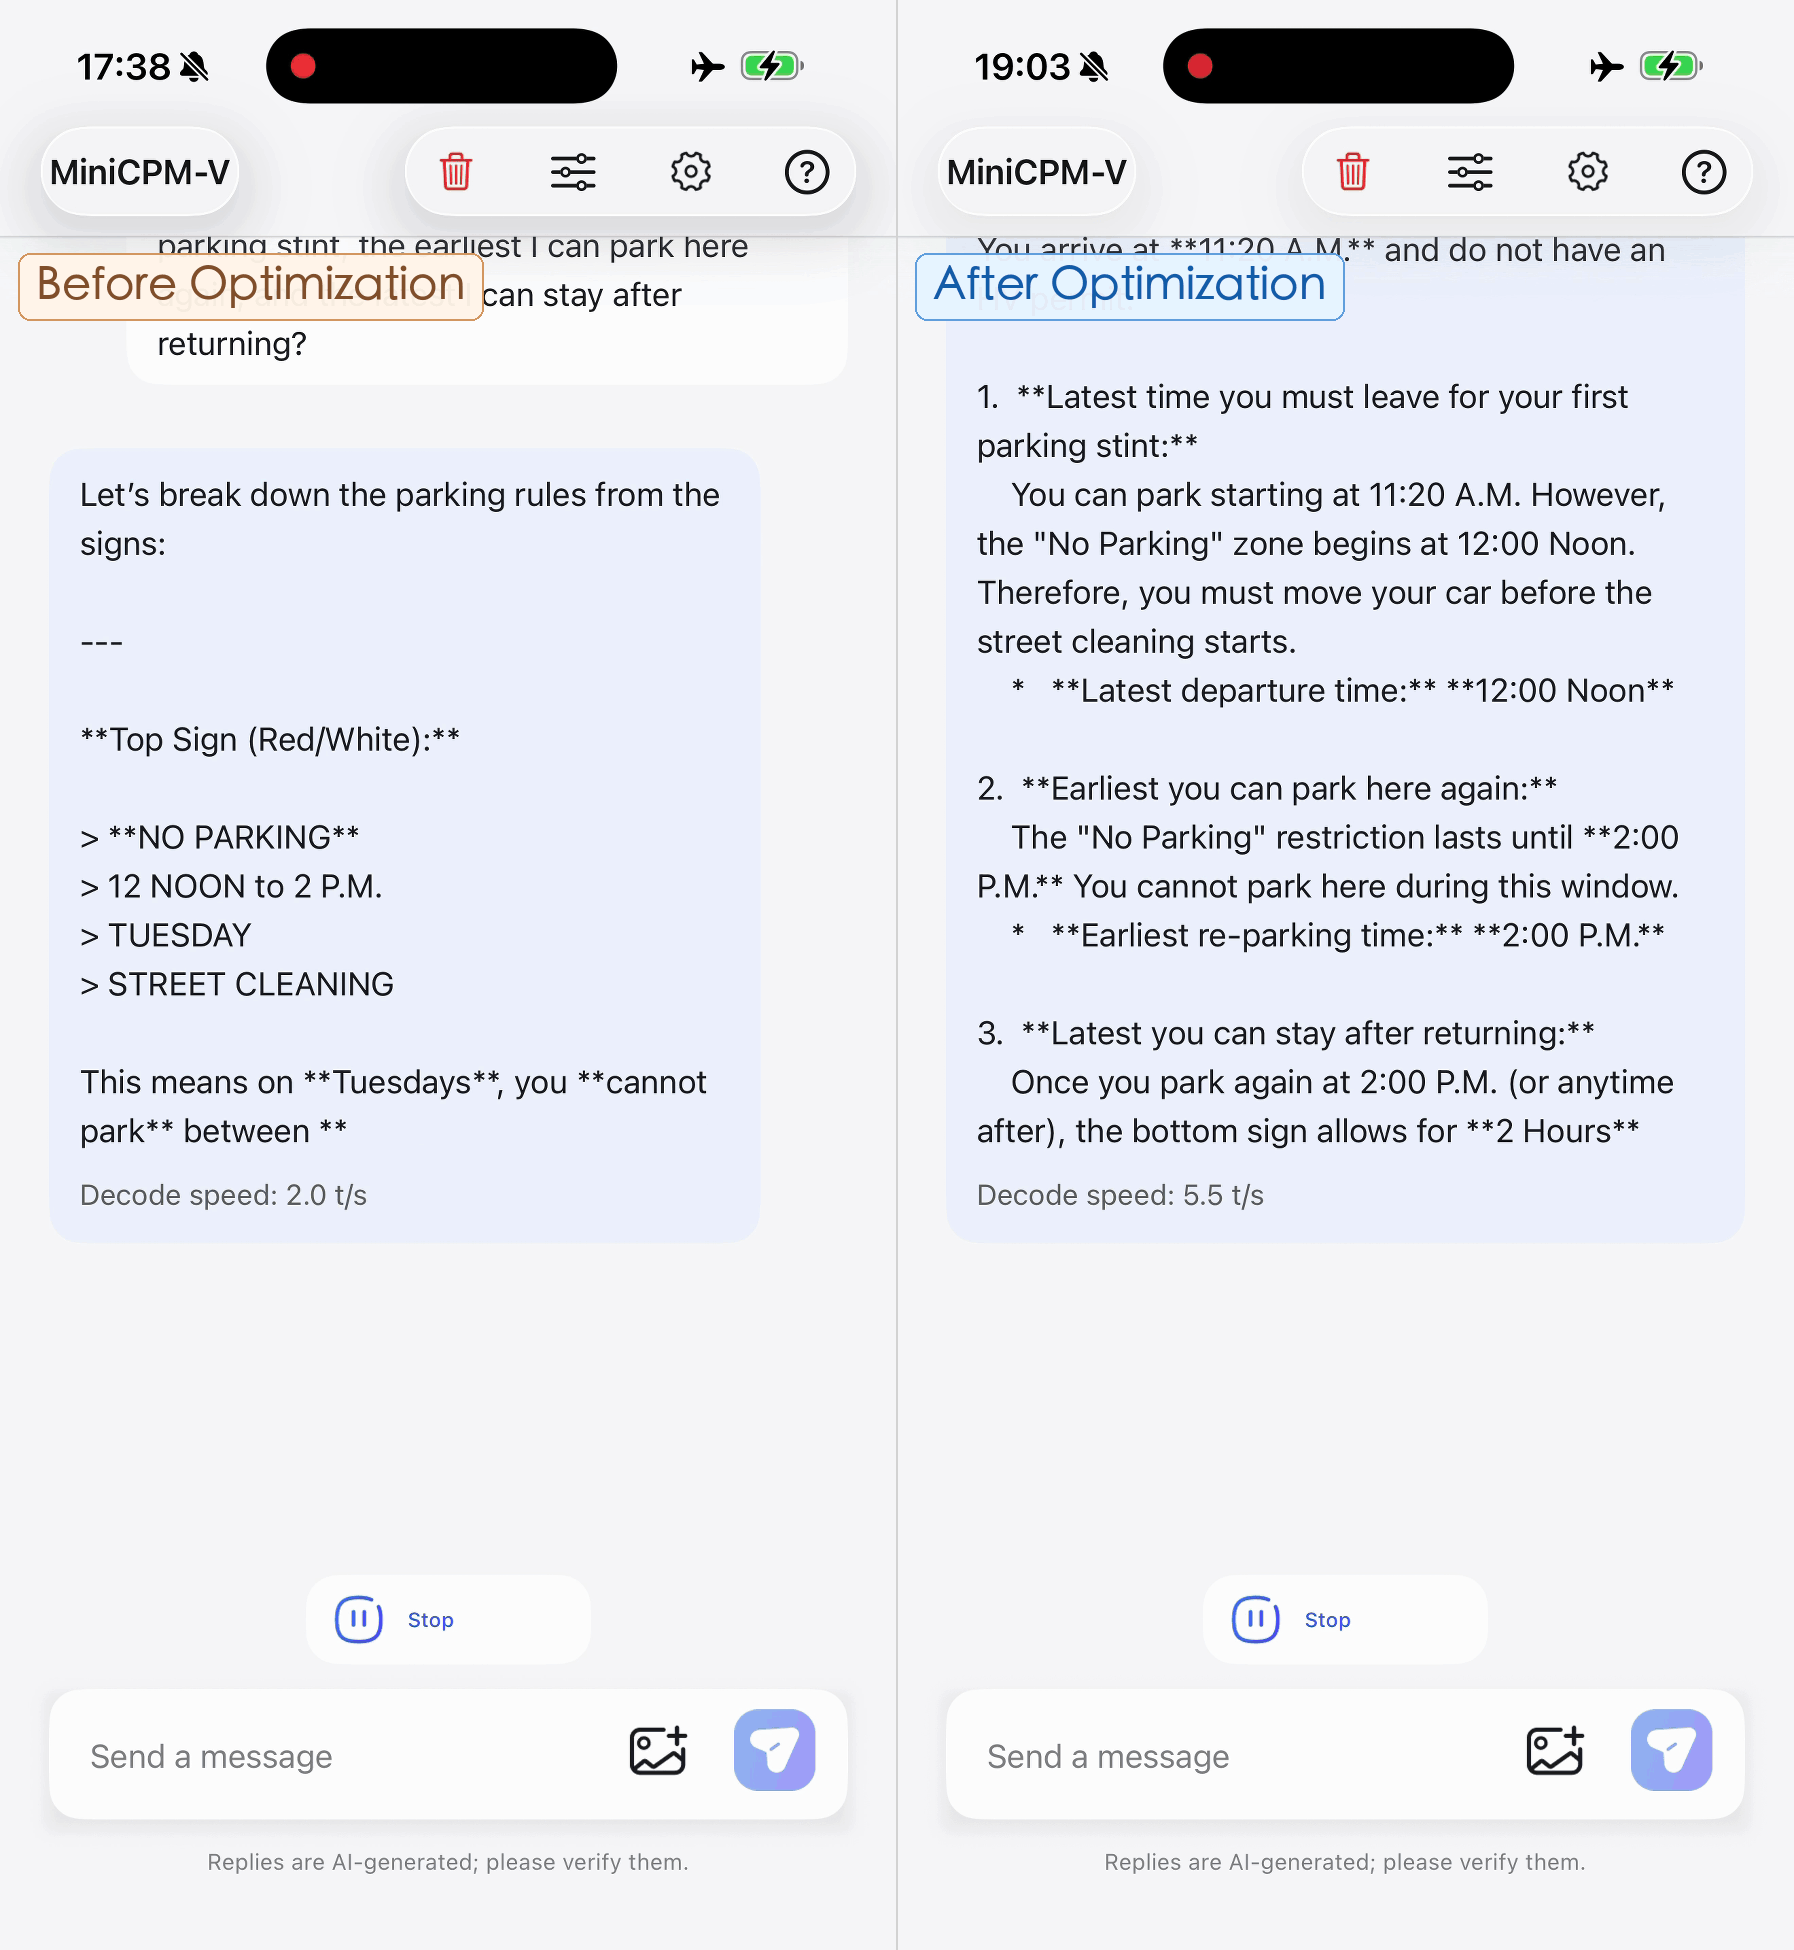
评估
显著推进性能–效率帕累托前沿
MiniCPM-V 4.7 的 35B-A3B 变体推进了性能–效率帕累托前沿。在 Instruct 模式下,35B-A3B 以比 Qwen3.6 35B-A3B 更少的推理时间达到了更高的总体得分。
总体性能(35B-A3B,Instruct)
视觉-语言
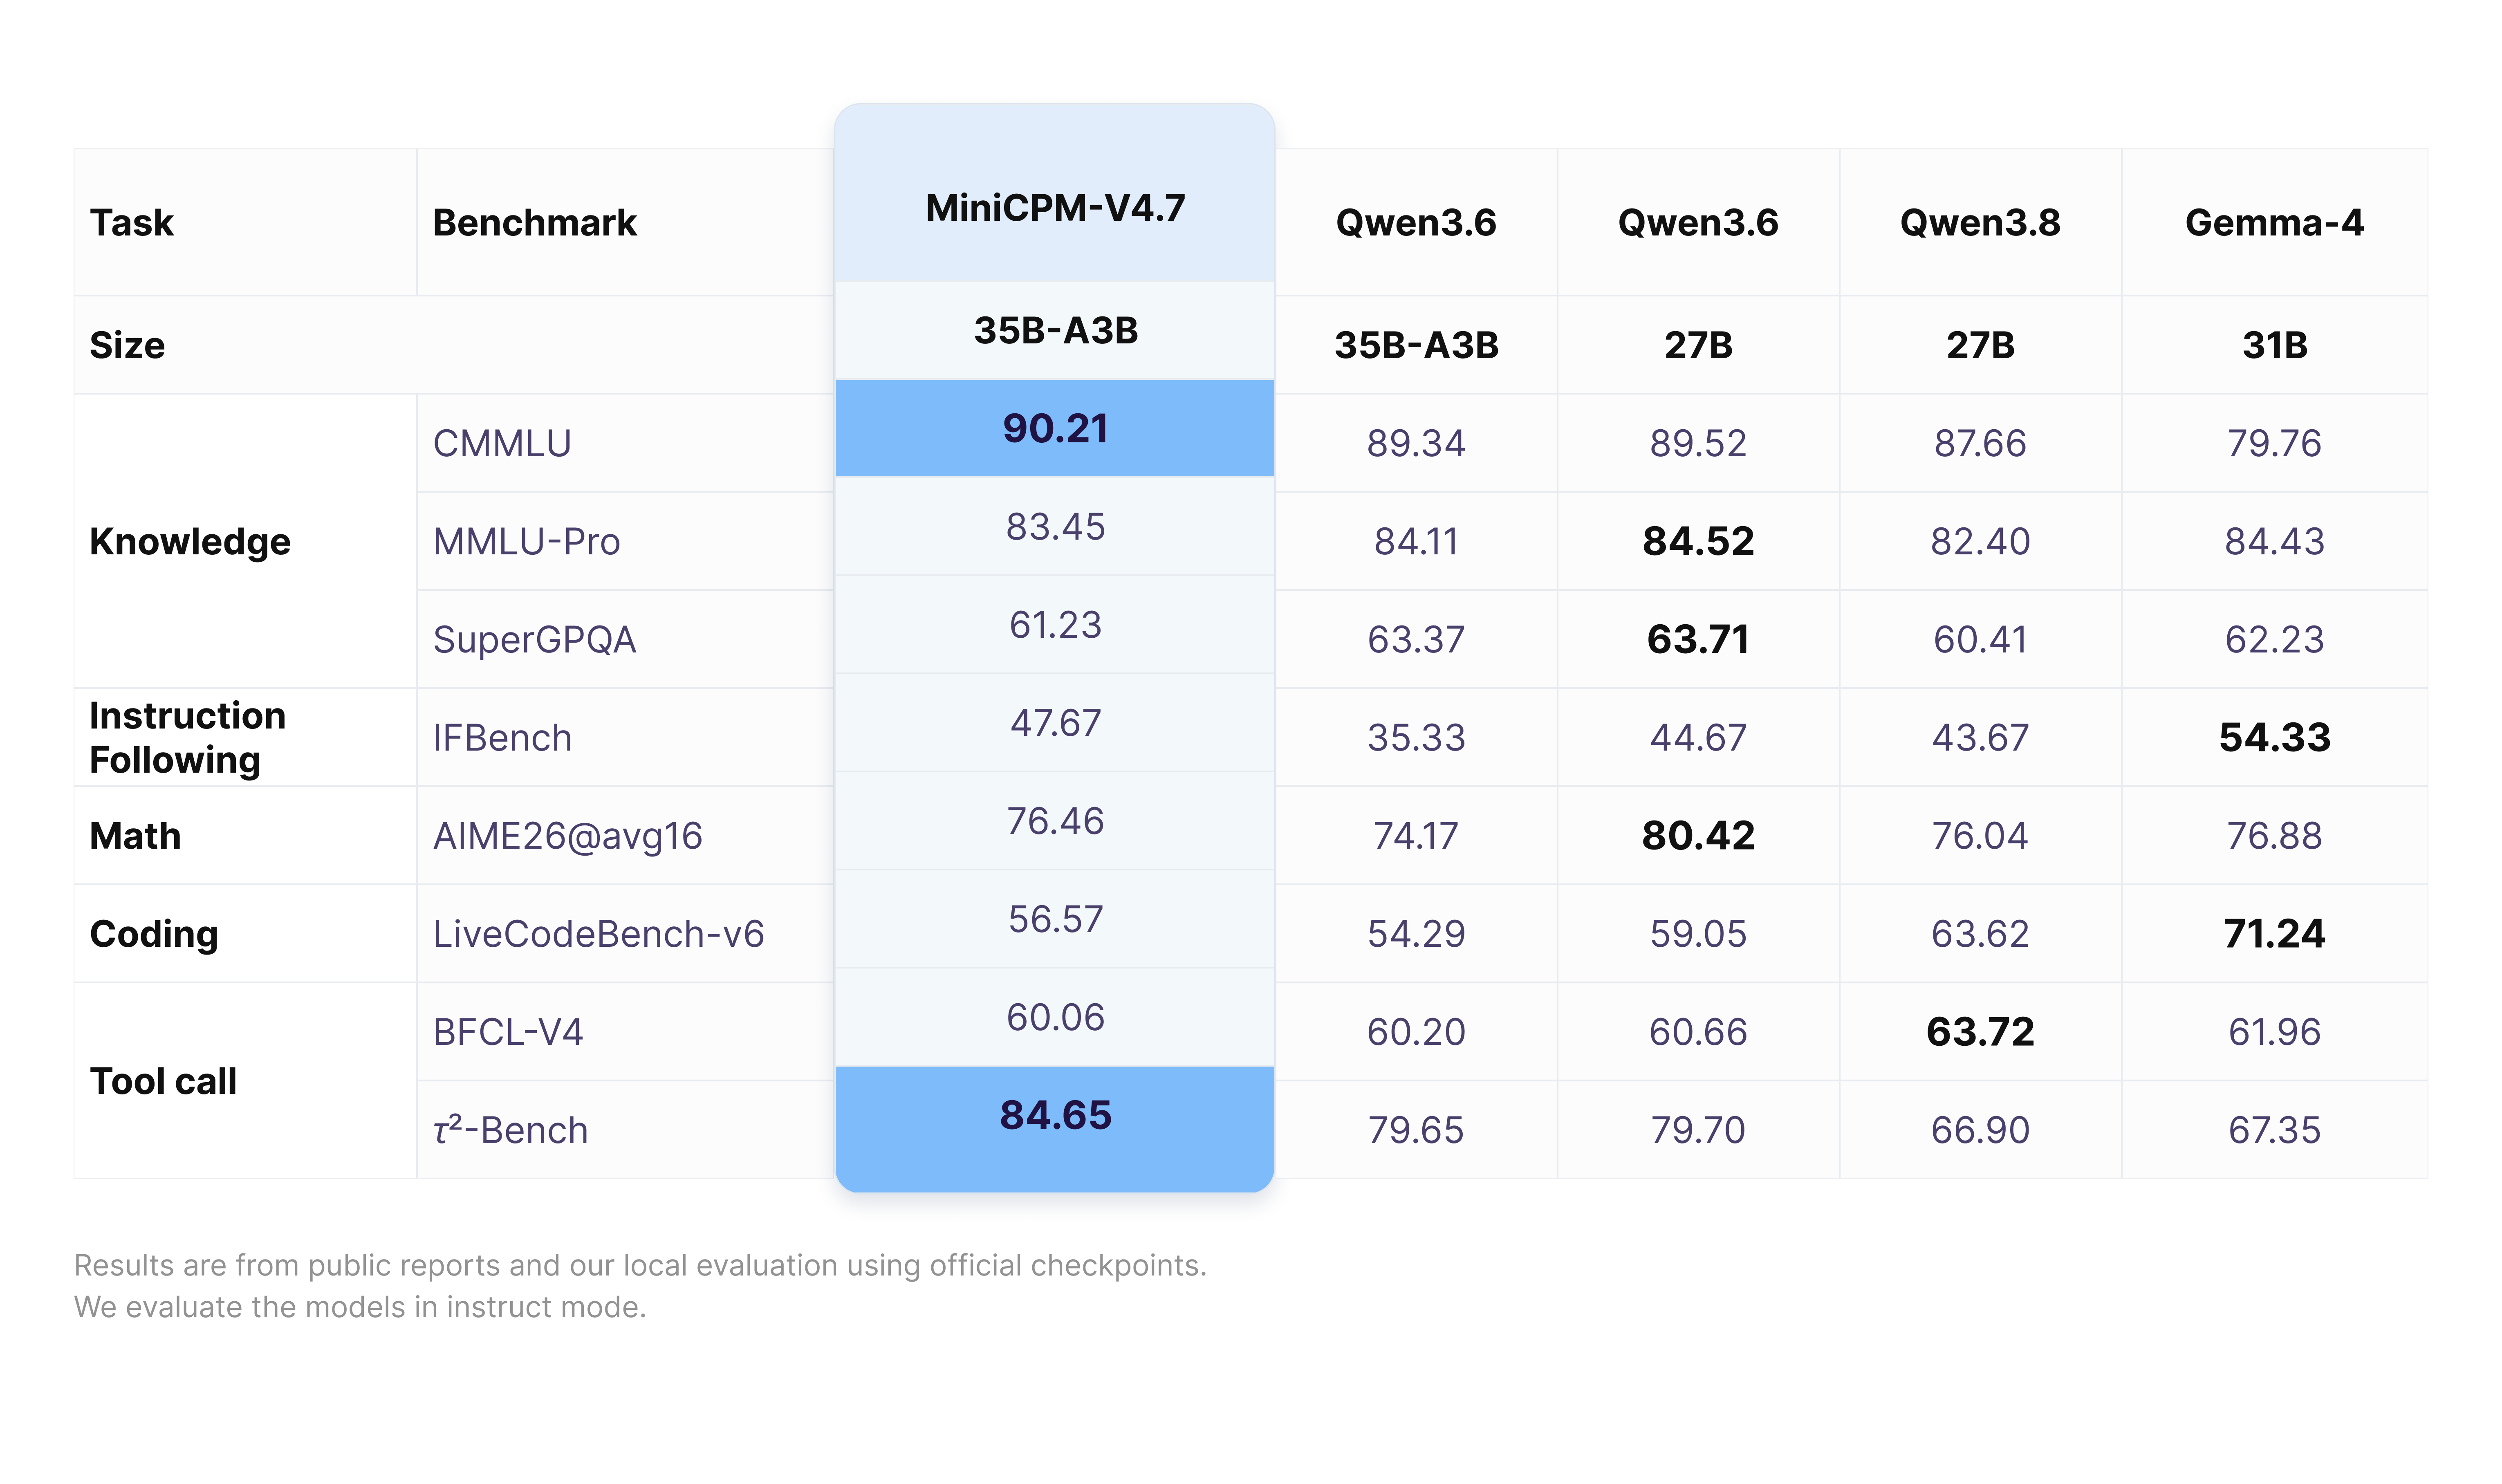
语言
示例
MiniCPM-V 4.7 可在手机和平板上运行。以下片段是直接在设备上录制的未经剪辑的屏幕录像。
使用方法
使用 Transformers 进行推理
点击展开 Transformers 推理示例。
安装
pip install "transformers[torch]>=5.18.0" torchvision torchcodec
关于 CUDA 兼容性的说明:
torchcodec(用于视频解码)可能与某些 CUDA 版本存在兼容性问题。例如,torch>=2.11默认捆绑 CUDA 13.1,而 CUDA 12.x 环境可能遇到RuntimeError: Could not load libtorchcodec等错误。有两种解决方法:
- Replace
torchcodecwithPyAV— supports both image and video inference without CUDA version constraints:pip install "transformers[torch]>=5.18.0" torchvision av- Pin the CUDA version when installing torch to match your environment (e.g. CUDA 12.8):
pip install "transformers>=5.18.0" torchvision torchcodec --index-url https://download.pytorch.org/whl/cu128
加载模型
import torch
from transformers import AutoModelForImageTextToText, AutoProcessor

model_id = "openbmb/MiniCPM-V-4.7-35B-A3B"

processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForImageTextToText.from_pretrained(
    model_id, torch_dtype="auto", device_map="auto"
)

# Flash Attention 2 is recommended for faster inference and lower GPU memory usage,
# especially in multi-image and video scenarios.
# model = AutoModelForImageTextToText.from_pretrained(
#     model_id,
#     torch_dtype=torch.bfloat16,
#     attn_implementation="flash_attention_2",
#     device_map="auto",
# )
图像推理
messages = [
    {
        "role": "user",
        "content": [
            {"type": "image", "url": "https://hf-mirror.com/datasets/openbmb/DemoCase/resolve/main/refract.png"},
            {"type": "text", "text": "What causes this phenomenon?"},
        ],
    }
]

downsample_mode = "16x"  # Using `downsample_mode="4x"` for Finer Detail

inputs = processor.apply_chat_template(
    messages, tokenize=True, add_generation_prompt=True,
    return_dict=True, return_tensors="pt",
    downsample_mode=downsample_mode,
    max_slice_nums=36,
    enable_thinking=False,
).to(model.device)

generated_ids = model.generate(
    **inputs,
    downsample_mode=downsample_mode,
    max_new_tokens=512,
    # recommended instruct-mode sampling parameters
    do_sample=True,
    temperature=0.7,
    top_p=0.95,
    top_k=100,
    min_p=0.0,
    presence_penalty=0,
    repetition_penalty=1.03,
)
generated_ids_trimmed = [
    out_ids[len(in_ids):] for in_ids, out_ids in zip(inputs.input_ids, generated_ids)
]
output_text = processor.batch_decode(
    generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
)
print(output_text[0])
视频推理
messages = [
    {
        "role": "user",
        "content": [
            {"type": "video", "url": "https://hf-mirror.com/datasets/openbmb/DemoCase/resolve/main/football.mp4"},
            {"type": "text", "text": "Describe this video in detail. Follow the timeline and focus on on-screen text, interface changes, main actions, and scene changes."},
        ],
    }
]

downsample_mode = "16x"  # Using `downsample_mode="4x"` for Finer Detail

inputs = processor.apply_chat_template(
    messages, tokenize=True, add_generation_prompt=True,
    return_dict=True, return_tensors="pt",
    downsample_mode=downsample_mode,
    max_num_frames=128,
    stack_frames=1,
    max_slice_nums=1,
    use_image_id=False,
    enable_thinking=False,
).to(model.device)

generated_ids = model.generate(
    **inputs,
    downsample_mode=downsample_mode,
    max_new_tokens=2048,
    # recommended instruct-mode sampling parameters
    do_sample=True,
    temperature=0.7,
    top_p=0.95,
    top_k=100,
    min_p=0.0,
    presence_penalty=0,
    repetition_penalty=1.03,
)
generated_ids_trimmed = [
    out_ids[len(in_ids):] for in_ids, out_ids in zip(inputs.input_ids, generated_ids)
]
output_text = processor.batch_decode(
    generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
)
print(output_text[0])
高级参数
你可以通过向 apply_chat_template 传递额外参数来自定义图像/视频处理:
| 参数 | 默认值 | 适用对象 | 说明 |
|---|---|---|---|
downsample_mode |
"16x" |
图像与视频 | 视觉 token 下采样。"16x" 会合并 token 以提高效率;"4x" 保留四倍数量的 token 以获得更精细的细节。还必须同时传递给 generate()。 |
max_slice_nums |
9 |
图像与视频 | 拆分高分辨率图像时的最大切片数。数值越高,大图像的细节保留越多。推荐:图像使用 36,视频使用 1。 |
max_num_frames |
128 |
仅视频 | 从视频中采样的最大主帧数。 |
stack_frames |
1 |
仅视频 | 每秒的总采样点数。1 = 仅主帧(不堆叠)。N(N>1)= 每秒 1 个主帧 + N−1 个子帧;子帧会被合成为网格图像并与主帧交错排列。推荐:3 或 5。 |
use_image_id |
True |
图像与视频 | 是否在每个图像/帧占位符前添加 <image_id>N</image_id> 标签。推荐:图像使用 True,视频使用 False。 |
注意:
downsample_mode必须同时传递给apply_chat_template(以获得正确的占位符数量)和generate(供视觉编码器使用)。所有其他参数只需传递给apply_chat_template。
使用 transformers serve 提供服务
HF Mirror Transformers 包含一个轻量级的 OpenAI 兼容服务器,用于快速测试和中等负载部署。
pip install "transformers[serving]>=5.18.0"
启动服务器:
transformers serve openbmb/MiniCPM-V-4.7-35B-A3B --port 8000 --host 0.0.0.0
发送请求:
curl -s http://localhost:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "openbmb/MiniCPM-V-4.7-35B-A3B",
    "messages": [{
      "role": "user",
      "content": [
        {"type": "image_url", "image_url": {"url": "https://hf-mirror.com/datasets/openbmb/DemoCase/resolve/main/refract.png"}},
        {"type": "text", "text": "What causes this phenomenon?"}
      ]
    }]
  }'
工具调用示例:
curl -s http://localhost:8000/v1/chat/completions -H 'Content-Type: application/json' -d '{
  "model": "openbmb/MiniCPM-V-4.7-35B-A3B",
  "messages": [{"role": "user", "content": [
    {"type": "text", "text": "the weather of Beijing"}
  ]}],
  "tools": [{
    "type": "function",
    "function": {
      "name": "get_weather",
      "description": "Get the current weather for a given location",
      "parameters": {
        "type": "object",
        "properties": {
          "location": {"type": "string", "description": "City name"}
        },
        "required": ["location"]
      }
    }
  }]
}'
推荐的采样参数
我们推荐在指令模式下生成时使用以下采样参数组合:temperature=0.7、top_p=0.95、top_k=100、min_p=0.0、presence_penalty=0、repetition_penalty=1.03。
投机解码(DSpark)
点击查看投机解码。
投机解码(DSpark):我们还发布了 MiniCPM-V-4.7-35B-A3B-DSpark,这是一个为 MiniCPM-V-4.7-35B-A3B 训练的 DSpark 草稿模型。
使用 OpenVINO™ 推理
OpenVINO™ 是一个开源工具包,用于在 Intel CPU/GPU/NPU 平台上优化和部署 AI 推理。OpenVINO 为 Intel 平台上的 MiniCPM-V-4.7 提供首日支持,并实现高性能推理。请参阅 OpenVINO™ 工具包 开始使用。你可以使用 此 notebook 安装并运行示例。
端侧部署
MiniCPM-V 4.7 支持在 iOS、Android 和 HarmonyOS 上部署,并为 Rockchip、Houmo、Intel、AMD 和 Arm 芯片平台提供首日支持。请参阅 边缘部署仓库 获取应用和源代码。
推理与微调
有关支持的推理和训练框架,请参阅 支持的推理与训练框架及 API。MiniCPM-V 4.7 Cookbook 涵盖部署、微调和量化工作流。
任务指南
量化
| 方法 | 指南 |
|---|---|
| GGUF | 量化指南 |
| BNB | 量化指南 |
| AWQ | 量化指南 |
| GPTQ | 量化指南 |
| FP8 / INT4 | 量化指南 |
致谢
点击查看致谢。
我们想感谢以下项目:
- Qwen3.5 和 Qwen3.6 提供语言主干
- SigLIP2 用于提供视觉理解模块
- Transformers
模型权重
MiniCPM-V 4.7 提供 35B-A3B 和 1B 两种变体。每个模型都搭配其 DSpark 投机解码头,提供 BF16 和 GGUF 格式。
| 模型 | 描述 | 模型权重 | DSpark 头 |
|---|---|---|---|
| MiniCPM‑V 4.7 35B-A3B |
首个开源 MoE 模型, 可在设备端流畅运行而不 牺牲性能,提升了 设备端性能的标准。 |
🤗  BF16 🤗 FP8🤗 int4🤗 AWQ🤗 GPTQ🤗 GGUF
|
🤗 BF16 🤗 GGUF
|
| MiniCPM‑V 4.7 1B |
将更强的能力 与极高的效率相结合, 推进了多模态 大语言模型的性能–效率 帕累托前沿。 |
🤗 BF16 🤗 int4🤗 AWQ🤗 GPTQ🤗 GGUF
|
🤗 BF16 🤗 GGUF
|
1B int4 变体使用 bitsandbytes;AWQ 和 GPTQ 使用 W4A16 量化。量化变体可减少内存占用;GGUF 权重支持 CPU 推理。
每个 GGUF 仓库还附带一个 thinking/ 子文件夹,其中包含相同量化级别、后缀为 -thinking 的文件。这些文件恢复了上游聊天模板,因此会输出 [Start thinking] … [End thinking] 轨迹;仓库根目录下的文件则保持思考功能禁用。
两组文件的张量权重完全相同,仅嵌入的模板不同。
也可在 Ollama 上获取。
来源:面壁 MiniCPM 模型发布 · hf-mirror.com